

看到一段效果不错的视频,想用 AI 复刻出来,多数人第一步就走错了:让模型「猜原作者的提示词」。猜出来的东西往往形似神不似——因为模型看得见画面,看不见镜头是怎么切的、声音是怎么铺的。更稳的做法是先反推结构,再写生成提示词。下面这套指令把流程拆成六步,可以直接复制给模型用。
六步流程
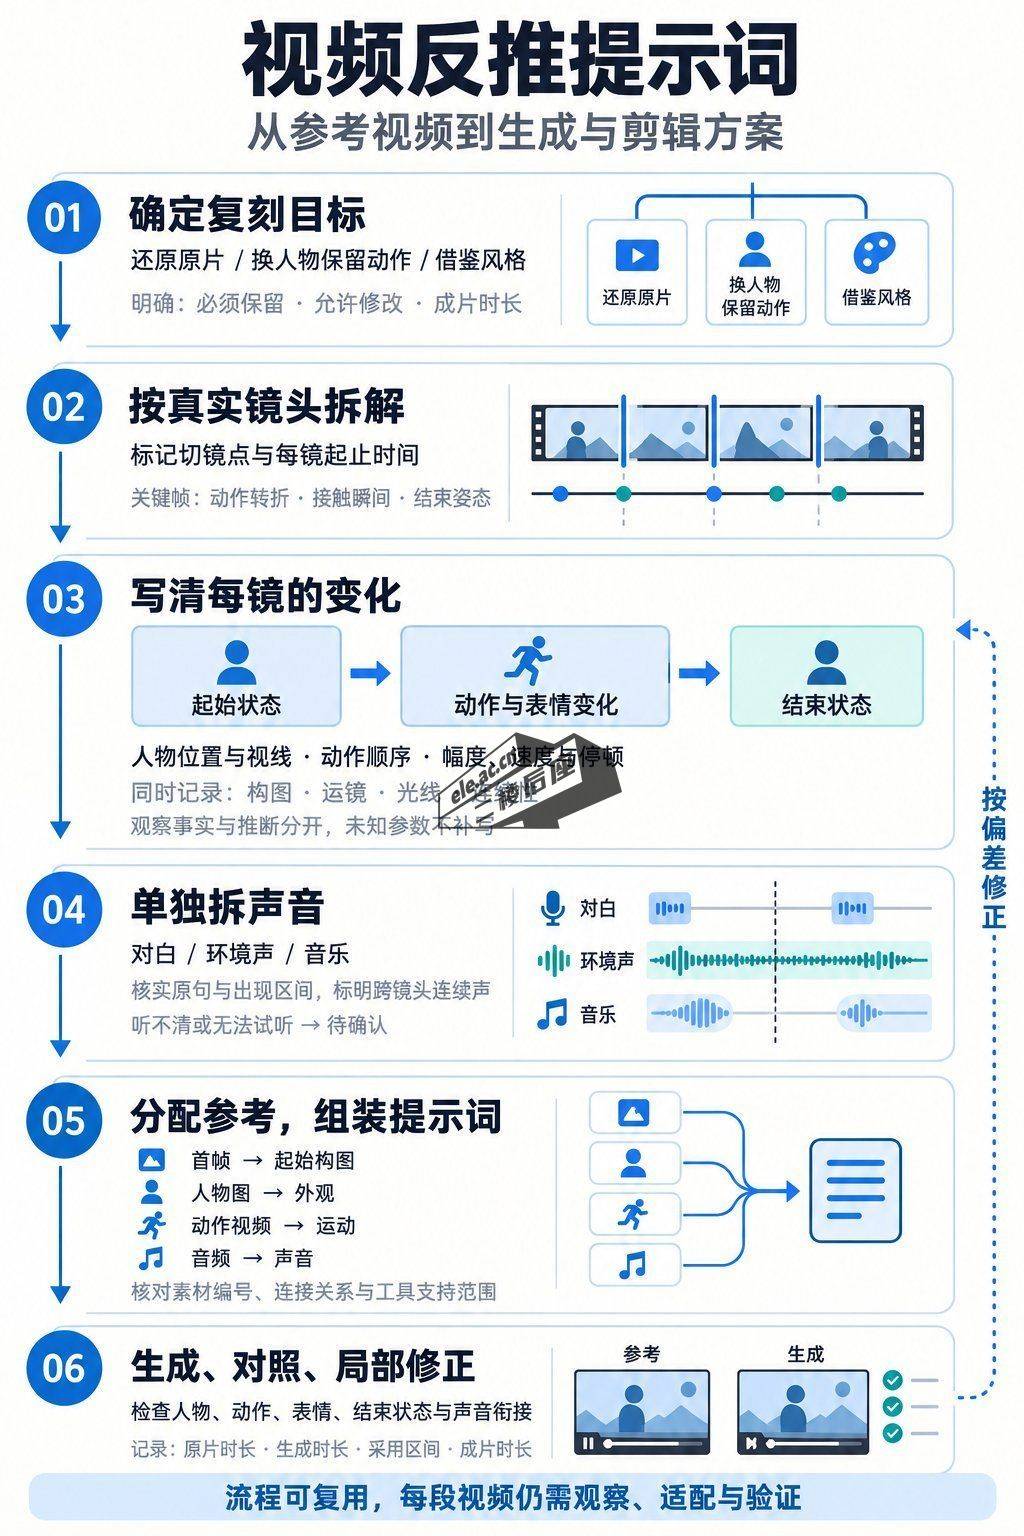
01 确定复刻目标
先分清要的是哪一种:完全还原原片、换人物但保留动作、还是只借鉴风格。同时把约束写死——哪些必须保留(动作时机、镜头数量),哪些允许改(服装、场景),成片要多久。目标不清,后面所有拆解都会跑偏。
02 按真实镜头拆解
记录时长、画幅和真实的切镜点,按镜头分段。关键帧只挑四类:动作转折、接触瞬间、结束姿态、切镜点,不必逐帧罗列。时间看不准就写「约」。
03 写清每镜的变化
每一镜按「起始状态 → 动作与表情变化 → 结束状态」写。动作要落到顺序、幅度、速度和停顿上,同时记录构图、景别、前后景、运镜和光线。观察到的和推断出来的必须分开写,看不清的参数标待确认,不要补写。
04 单独拆声音
对白、环境声、音乐分三条记,各自标出出现区间。特别注意跨镜头连续的声音(一段音乐压过三个镜头)和随动作出现的声音(关门、落水)。听不清就标待确认。
05 分配参考素材,组装提示词
把手上每张图、每段视频、每段音频的职责定下来:这张管人物外观,那张管起止画面,这段管动作,那段管机位或声音;核对素材编号和连接关系。然后逐镜写提示词——起始状态 → 核心变化 → 动作节奏 → 结束状态,有首帧的以动态描述为主。
06 生成、对照、局部修正
拿到结果后逐项对照参考:人物、动作、表情、结束状态、声音衔接。记录原片时长、生成时长、实际采用区间和成片时长,方便下一轮修正。
可直接复制的完整指令
下面这段可以整段复制给模型,做视频理解或直接生成都适用:
请根据参考视频,重建一个可执行的视频生成与剪辑方案。不要猜原作者的提示词,也不要只罗列人物、场景和风格标签。

一、识别结构
记录视频时长、画幅、真实切镜点,按镜头分段。时间不能精确确认时,标注为约值。

二、拆解每个镜头
记录:
- 人物与环境的起始状态;
- 视线对象、动作和表情变化的先后顺序;
- 动作幅度、速度、停顿和明确的结束状态;
- 景别、前后景关系、可见运镜与光线变化;
- 需要保持的身份、服装、站位和空间关系。
选择切镜点、动作转折点、接触瞬间和结束姿态作为关键帧,不必逐帧罗列。

三、单独拆解声音
分别记录对白、环境声、音乐及其出现区间。注明哪些声音连续跨越镜头,哪些声音随动作出现。听不清或无法试听的内容标为待确认,不补写台词或声音事实。

四、确定参考素材的职责
明确每张图片、每段视频和音频分别负责:人物外观、起止画面、动作、机位、场景或声音。核对实际素材编号和连接关系。

五、编写生成提示词
每镜包含:起始状态 → 核心变化 → 动作节奏 → 结束状态。有首帧时以动态描述为主。仅保留必要的连续性约束和针对性限制。把直接观察、合理推断、生成选择分别标明。

六、输出完整执行方案
- 逐镜视频提示词;
- 声音处理说明;
- 生成时长与剪辑采用区间;
- 镜序、转场和跨镜头声音安排;
- 对照参考的验收清单;
- 尚未确认或当前模型不支持的事项。
为什么这样设计
把「观察」和「推断」分开
这是全套指令里最要紧的一条。模型很容易把「看起来像」写成「就是」——服装颜色看不清就编一个。分开记之后,你才知道哪些字段可信、哪些需要补拍或换素材。
声音单独拆
画面拆完就以为完事,是复刻最常见的失败原因。声音决定剪辑点:对白在哪句断、音乐在哪一拍切,往往比画面的切镜点更硬。
先定素材职责,再写提示词
素材编号和连接关系没核对清,提示词再漂亮也对不上——模型会把你以为的「人物外观参考」当成首帧用。






暂无评论内容