

开源 TTS 项目在 GitHub 上有几十个,每个都说自己「像真人」。但选哪个不该看星数,该看你要干的活——这篇把 10 个能真正跑起来的项目按用途分成 4 组,每个给官方装法、一段能直接复制给 Agent 的话,还有它的坑和许可小字。
起这个念头的场景很具体:正在搭一套视频工作流,想把手里攒的素材做成视频,顺便在本地直接配个音,省掉录旁白那一步。
结果到 GitHub 一搜 TTS,几十个项目,每个都说自己像真人。点开 README,CUDA 版本、显存下限、许可证,一屏看下来信息量直接劝退。真正让人卡住的不是「找不到工具」,而是不知道哪个工具对应自己手上的活。
所以下面这 10 个按你要干的活分成了 4 组,每个都给官方装法、一段能直接复制给 Agent 的话,以及它真实的坑。星数全部是 2026 年 10 月核实的实测值,安装命令来自各仓库 README 或官方文档。
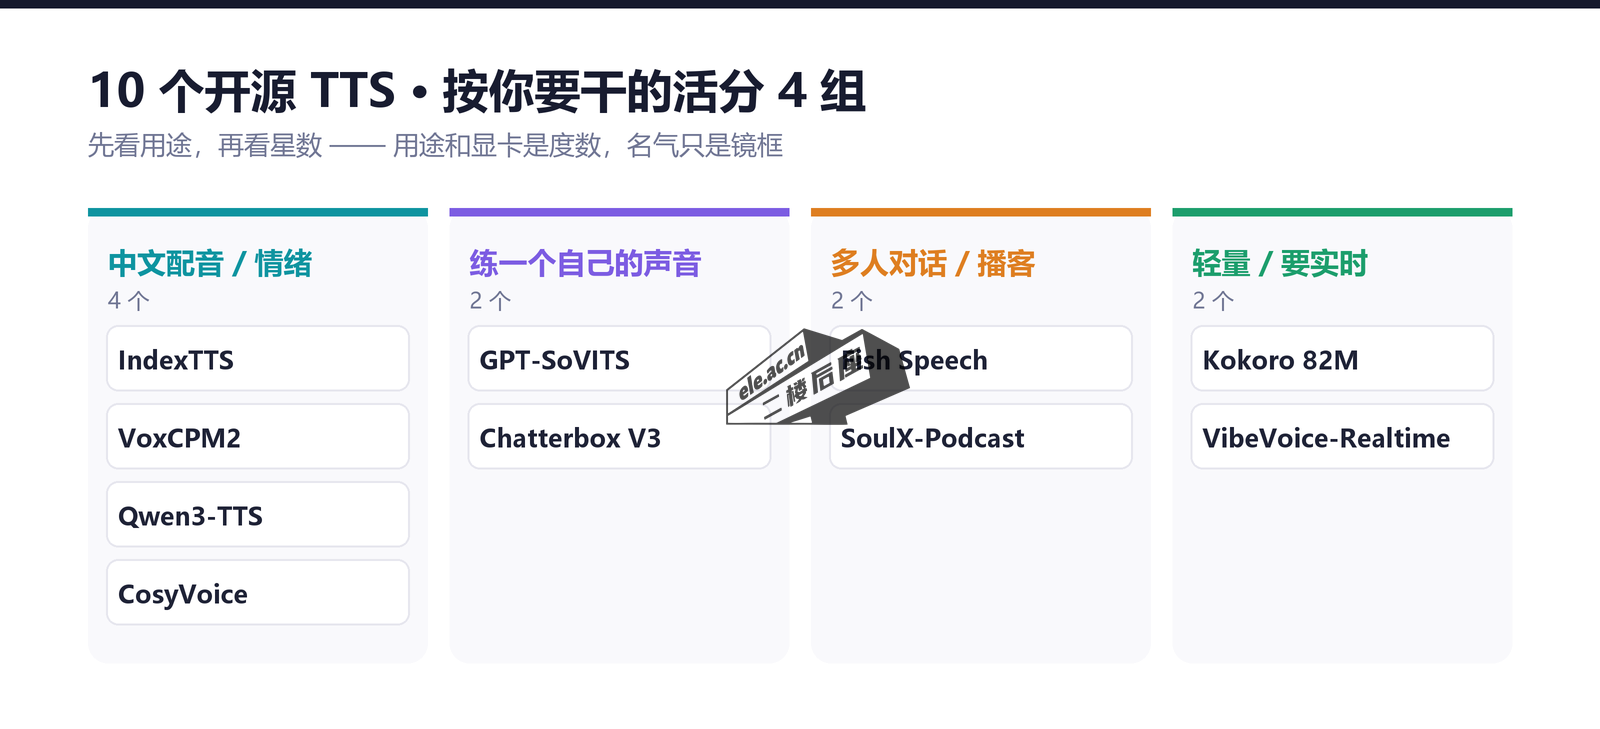
一、先别急着装:先看用途,再看星数
这个问题想通了,答案其实挺土的:先看用途,再看星数。
打个比方——去配眼镜要先验度数,再挑镜框。你的用途和显卡配置就是度数,哪个模型名气大只是镜框。度数不对,镜框再好看也戴不了。
对号入座的方式是这样的:
| 你的场景 | 直接看这一组 |
|---|---|
| 要中文配音、还要带情绪 | IndexTTS、VoxCPM、Qwen3-TTS、CosyVoice |
| 想把自己的声音练成专属模型,或直接克隆 | GPT-SoVITS、Chatterbox |
| 要多人对话、播客 | Fish Speech、SoulX-Podcast |
| 要轻量、要实时 | Kokoro、VibeVoice-Realtime |
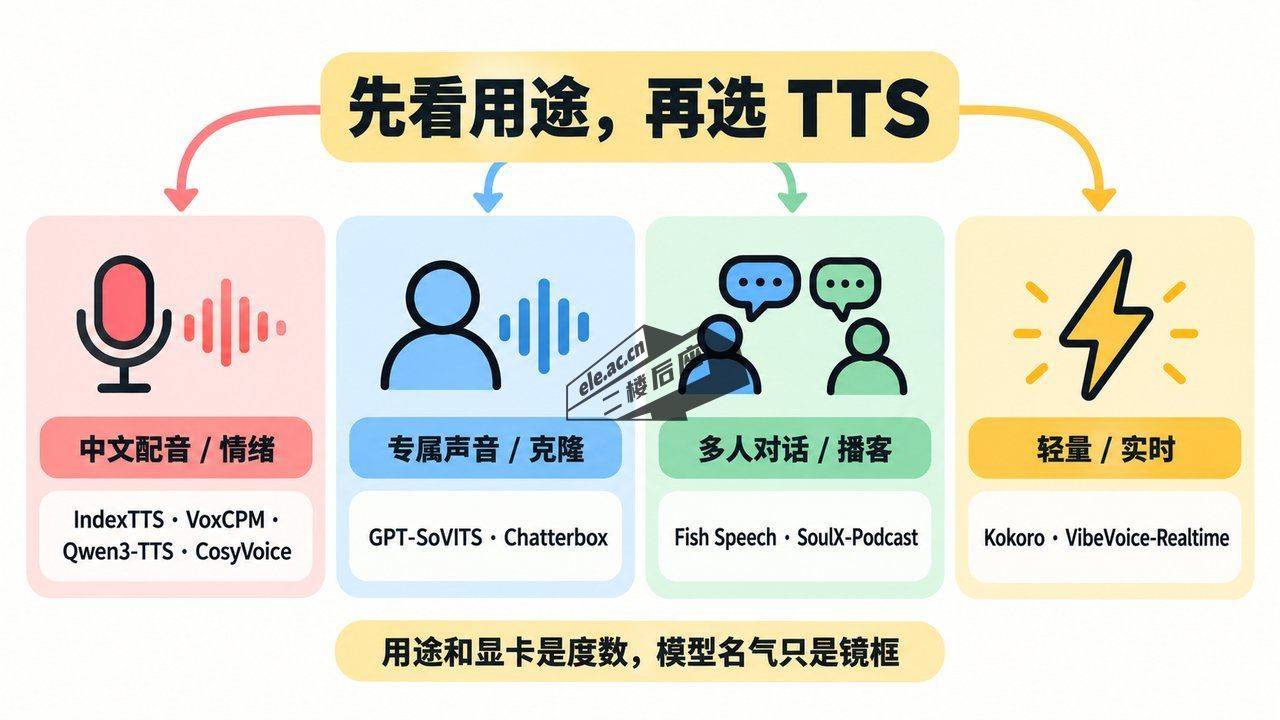
对上号了就跳到对应那一组看,不用从头读到尾。
二、中文配音主力:克隆 + 情绪(4 个)
① IndexTTS:B 站开源的零样本克隆
一段参考音就能克隆,而且音色和情绪可以分开控。最新是 IndexTTS-2.5(2026-08 发布),支持中英日西阿 5 种语言。情绪既能用参考音频控,也能用 8 维情绪向量控,还能用一句文字描述控;语速可调(duration_factor 0.5–2.0)。
最值得安利的功能是多音字处理:直接写拼音,比如 <行|HANG2>。配过长稿的人知道这个有多救命。
官方试听:index-tts.github.io
git clone https://github.com/index-tts/index-tts.git && cd index-tts
pip install -U uv
uv sync --all-extras
uv tool install "huggingface-hub"
hf download IndexTeam/IndexTTS-2.5 --local-dir=checkpoints
uv run webui.py
跑起来浏览器开 http://127.0.0.1:7860。想要 Agent 代劳,把下面这段直接丢过去:
帮我按 https://github.com/index-tts/index-tts 的 README 装 IndexTTS-2.5:用 uv sync 装依赖,下载 IndexTeam/IndexTTS-2.5 到 checkpoints,先跑 uv run tools/gpu_check.py 看显卡,再启动 uv run webui.py。国内网络慢就用 README 里的阿里云镜像和 HF_ENDPOINT=https://hf-mirror.com。
坑:必须用 uv 装,别自己先激活虚拟环境;Windows 上 DeepSpeed 难装,去掉 --all-extras 手动选;装的时候报 CUDA 错,需要 CUDA Toolkit 12.8 以上。
许可小字:它走的是 bilibili 模型使用协议,不是 Apache——月活超 1 亿或年营收超 10 亿元要单独申请授权,也不能拿它去改进别的商用模型。
② VoxCPM:一句话就能造一个新声音
这个挺有意思——它可以不要参考音频,你打一句「年轻女声,温柔一点」,它就给你造一个新声音。权重 Apache-2.0,能商用。
VoxCPM2 是 2B 参数,30 种语言,再加四川话、粤语、东北话等 9 种方言。三种用法:一句话描述造声(Voice Design)、短参考音克隆、带原文的高保真克隆。直接出 48kHz 音频。
官方试听:openbmb.github.io/voxcpm2-demopage · 在线试玩:Hugging Face Space
pip install voxcpm
voxcpm design --text "VoxCPM2 brings studio-quality multilingual speech synthesis." --output out.wav
voxcpm clone --text "This is a voice cloning demo." --reference-audio path/to/voice.wav --output out.wav
想要网页界面,就克隆仓库后跑 python app.py --port 8808。
坑:Python 要 ≥3.10 且 <3.13,3.13 装不上。VoxCPM2 显存大约 8GB,卡小就用 VoxCPM1.5(约 6GB,只有中英)。README 明确禁止拿它冒充他人、诈骗,也建议给 AI 生成内容打标——这条不算坑,算底线。
③ Qwen3-TTS:三合一的「嗓子库」
阿里千问出品,三合一:9 个现成音色(含北京话、四川话)、一句话造声、3 秒克隆。它拆成三种模型——CustomVoice 自带 9 个音色,能用「用特别愤怒的语气说」这种指令控情绪;VoiceDesign 用文字描述造声;Base 用 3 秒参考音克隆。10 种语言,流式首包延迟最低 97ms。
在线试玩:Hugging Face Space · 国内用:ModelScope 创空间
conda create -n qwen3-tts python=3.12 -y
conda activate qwen3-tts
pip install -U qwen-tts
qwen-tts-demo Qwen/Qwen3-TTS-12Hz-1.7B-CustomVoice --ip 0.0.0.0 --port 8000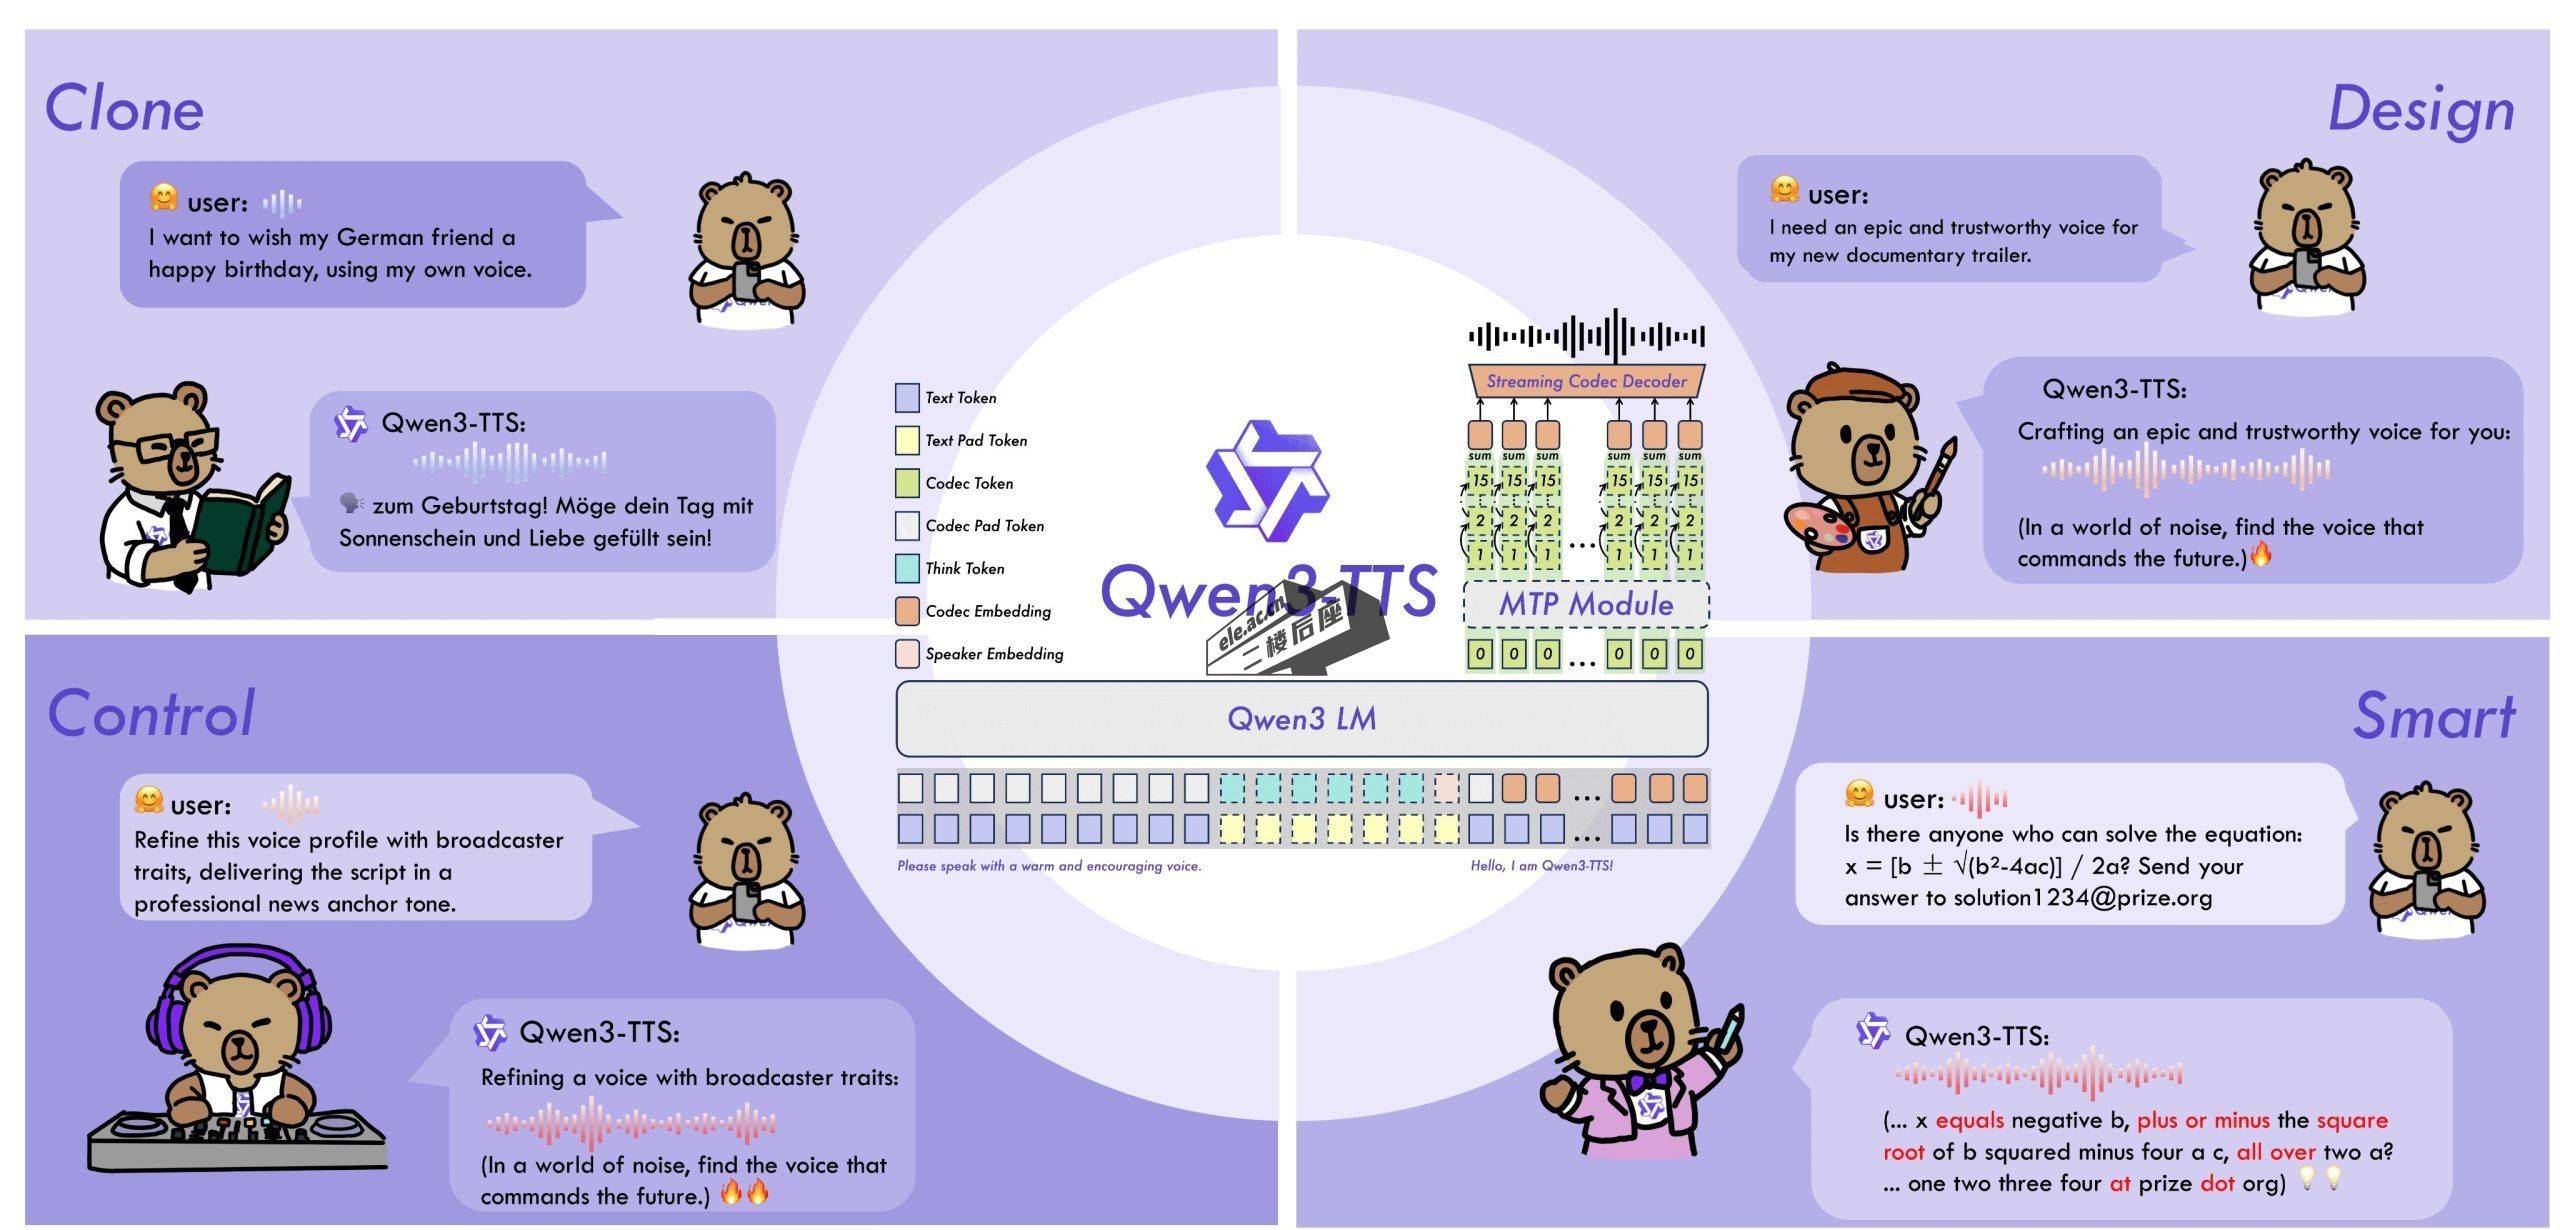
坑:README 推荐装 FlashAttention 2 省显存,但要显卡支持;内存不到 96GB 要加 MAX_JOBS=4 再装。想克隆记得用 Base 模型。网页 demo 要远程访问得开 HTTPS,不然浏览器不给麦克风权限。代码和权重都是 Apache-2.0。
④ CosyVoice:方言全家桶
通义实验室的老牌中文 TTS。18 种以上方言口音,数字、符号的读法也不用你另外处理。Fun-CosyVoice3-0.5B 支持 9 种语言,加粤语、闽南语、四川话、上海话等 18+ 方言,能跨语种克隆;支持拼音 / 音素纠正发音,还有 FastAPI、gRPC、vLLM、TensorRT-LLM 的部署方案。
它最适合要把配音接进流水线的人——部署方案给得最全,不是只能在本地点个按钮跑。
官方试听:qwenaudio.github.io/cosyvoice3
git clone --recursive https://github.com/QwenAudio/CosyVoice.git
cd CosyVoice
git submodule update --init --recursive
conda create -n cosyvoice -y python=3.10
conda activate cosyvoice
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
模型用 README 里的 snapshot_download('FunAudioLLM/Fun-CosyVoice3-0.5B-2512', local_dir='pretrained_models/Fun-CosyVoice3-0.5B') 下载,然后 python example.py。
坑:子模块经常克隆失败,就反复跑 git submodule update --init --recursive,别慌。还有个挺抽象的:仓库已经从 FunAudioLLM 迁到 QwenAudio,README 里旧的 demo 链接现在打不开,用上面那个新地址;自带的 webui.py 示例默认还是老的 CosyVoice-300M 模型。Apache-2.0。
三、练一个你自己的声音(2 个)
⑤ GPT-SoVITS:5 秒克隆,1 分钟素材就很像
这 10 个里星最多的就是它(62.9k)。5 秒能克隆,喂 1 分钟素材微调后会更像。对新手相当友好:WebUI 里自带人声伴奏分离、自动切片、中文 ASR 打标,训练集你自己就能做。支持中英日韩粤。
README 给的速度参考:4090 上 RTF 0.014,M4 CPU 上 0.526。
在线试玩:Hugging Face Space · 演示视频:B 站
conda create -n GPTSoVits python=3.10
conda activate GPTSoVits
bash install.sh --device <CU126|CU128|ROCM|CPU> --source <HF|HF-Mirror|ModelScope> [--download-uvr5]
python webui.py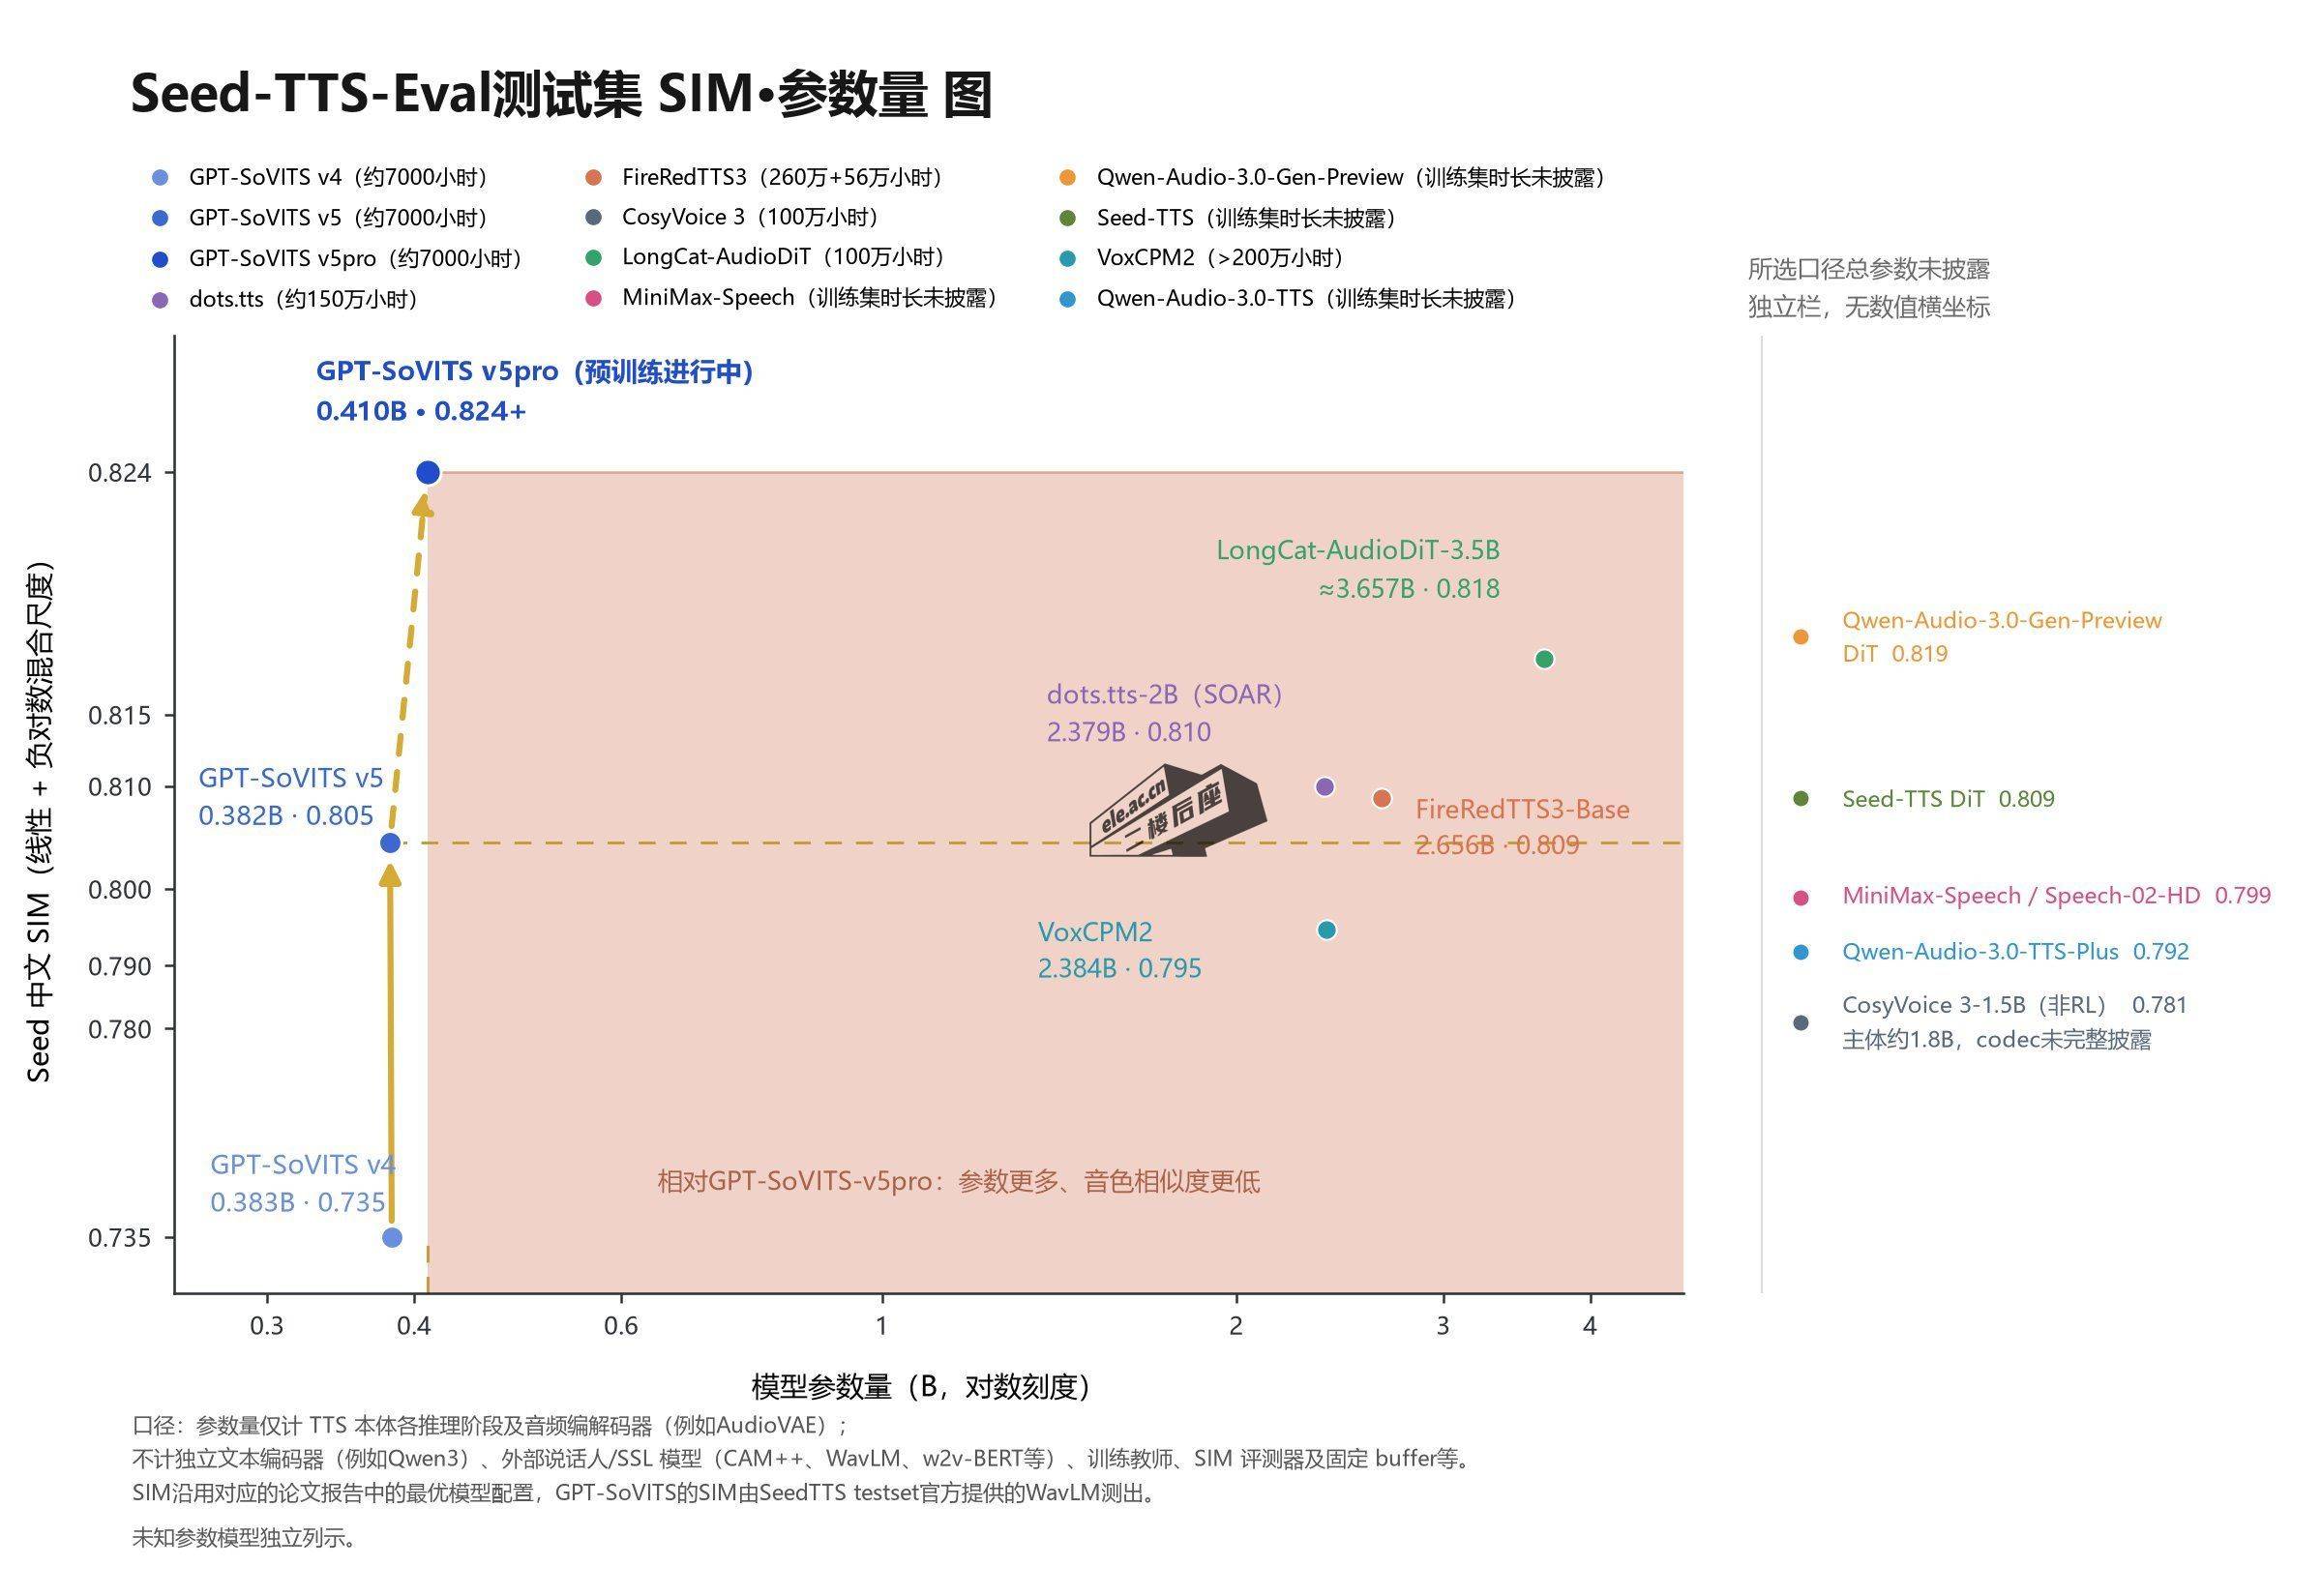
Windows 用户可以直接下 README 里的整合包,双击 go-webui.bat。坑:Mac 上用 GPU 训练出来的模型质量明显差,README 建议改用 CPU 训练。版本也多(v2Pro / v4 / v5),容易挑花眼——素材质量一般的,README 建议用 v1/v2/v2Pro。MIT。
⑥ Chatterbox:多语种克隆,许可很干净
Resemble AI 开源的克隆模型。给一段你自己的参考音,就能用你的声音念别的稿子,中文也在支持列表里。现在主推 Chatterbox Multilingual V3:0.5B 参数、23 种语言、能跨语种克隆;另外有个普通话精调版,想要中文更稳可以看它。还有个 exaggeration 参数调情绪夸张程度,默认 0.5。
许可这次很干净:代码 MIT,Hugging Face 上的权重(含普通话版)也标 MIT,能商用。
官方试听:resemble-ai.github.io/chatterbox_demopage · 在线试玩:多语种版 / 普通话版
conda create -yn chatterbox python=3.11
conda activate chatterbox
pip install chatterbox-tts
import torchaudio as ta
from chatterbox.mtl_tts import ChatterboxMultilingualTTS
model = ChatterboxMultilingualTTS.from_pretrained(device="cuda", t3_model="v3")
wav = model.generate("你好,今天天气真不错,希望你有一个愉快的周末。",
language_id="zh", audio_prompt_path="YOUR_FILE.wav")
ta.save("test-chinese.wav", wav, model.sr)
audio_prompt_path 换成你自己的录音就是克隆;去掉这个参数就用默认音色。没有 N 卡,device 可以填 "cpu" 或 "mps"。
坑:t3_model="v3" 一定要写——不写的话,README 说默认加载的是老的 V2 多语种权重。参考音的语言要和 language_id 对上,不然会带上参考音那门语言的口音;README 给的解法是把 cfg_weight 设成 0。另外 Turbo 和 Nano 这两个更轻的版本只支持英文;每条生成的音频都内置了 PerTh 隐形水印,README 说压成 MP3 也能检出。README 没给微调工具,想要「更像」主要靠参考音质量;依赖版本在 pyproject.toml 里钉死了(比如 torch==2.6.0),最好单独建环境。
四、多人对话 / 播客(2 个)
⑦ Fish Speech:一段剧本好几个角色一起配
改的时候还能像改文字一样,只改一个词重新生成。新旗舰 Drama 3 主打多角色、长对话、多轮「导演式」修改(「再温柔一点、再难过一点」),句子里写 [whisper]、[angry]、[laughing] 就能控情绪。上一代 S2-Pro 推理更快,约 100 种语言,10–30 秒参考音就能克隆。
官方试玩:fish.audio
conda create -n fish-speech python=3.12
conda activate fish-speech
pip install --extra-index-url https://download.pytorch.org/whl/cu129 -e ".[cu129]"
pip install -U "huggingface_hub[cli]"
hf download fishaudio/s2-pro --local-dir checkpoints/s2-pro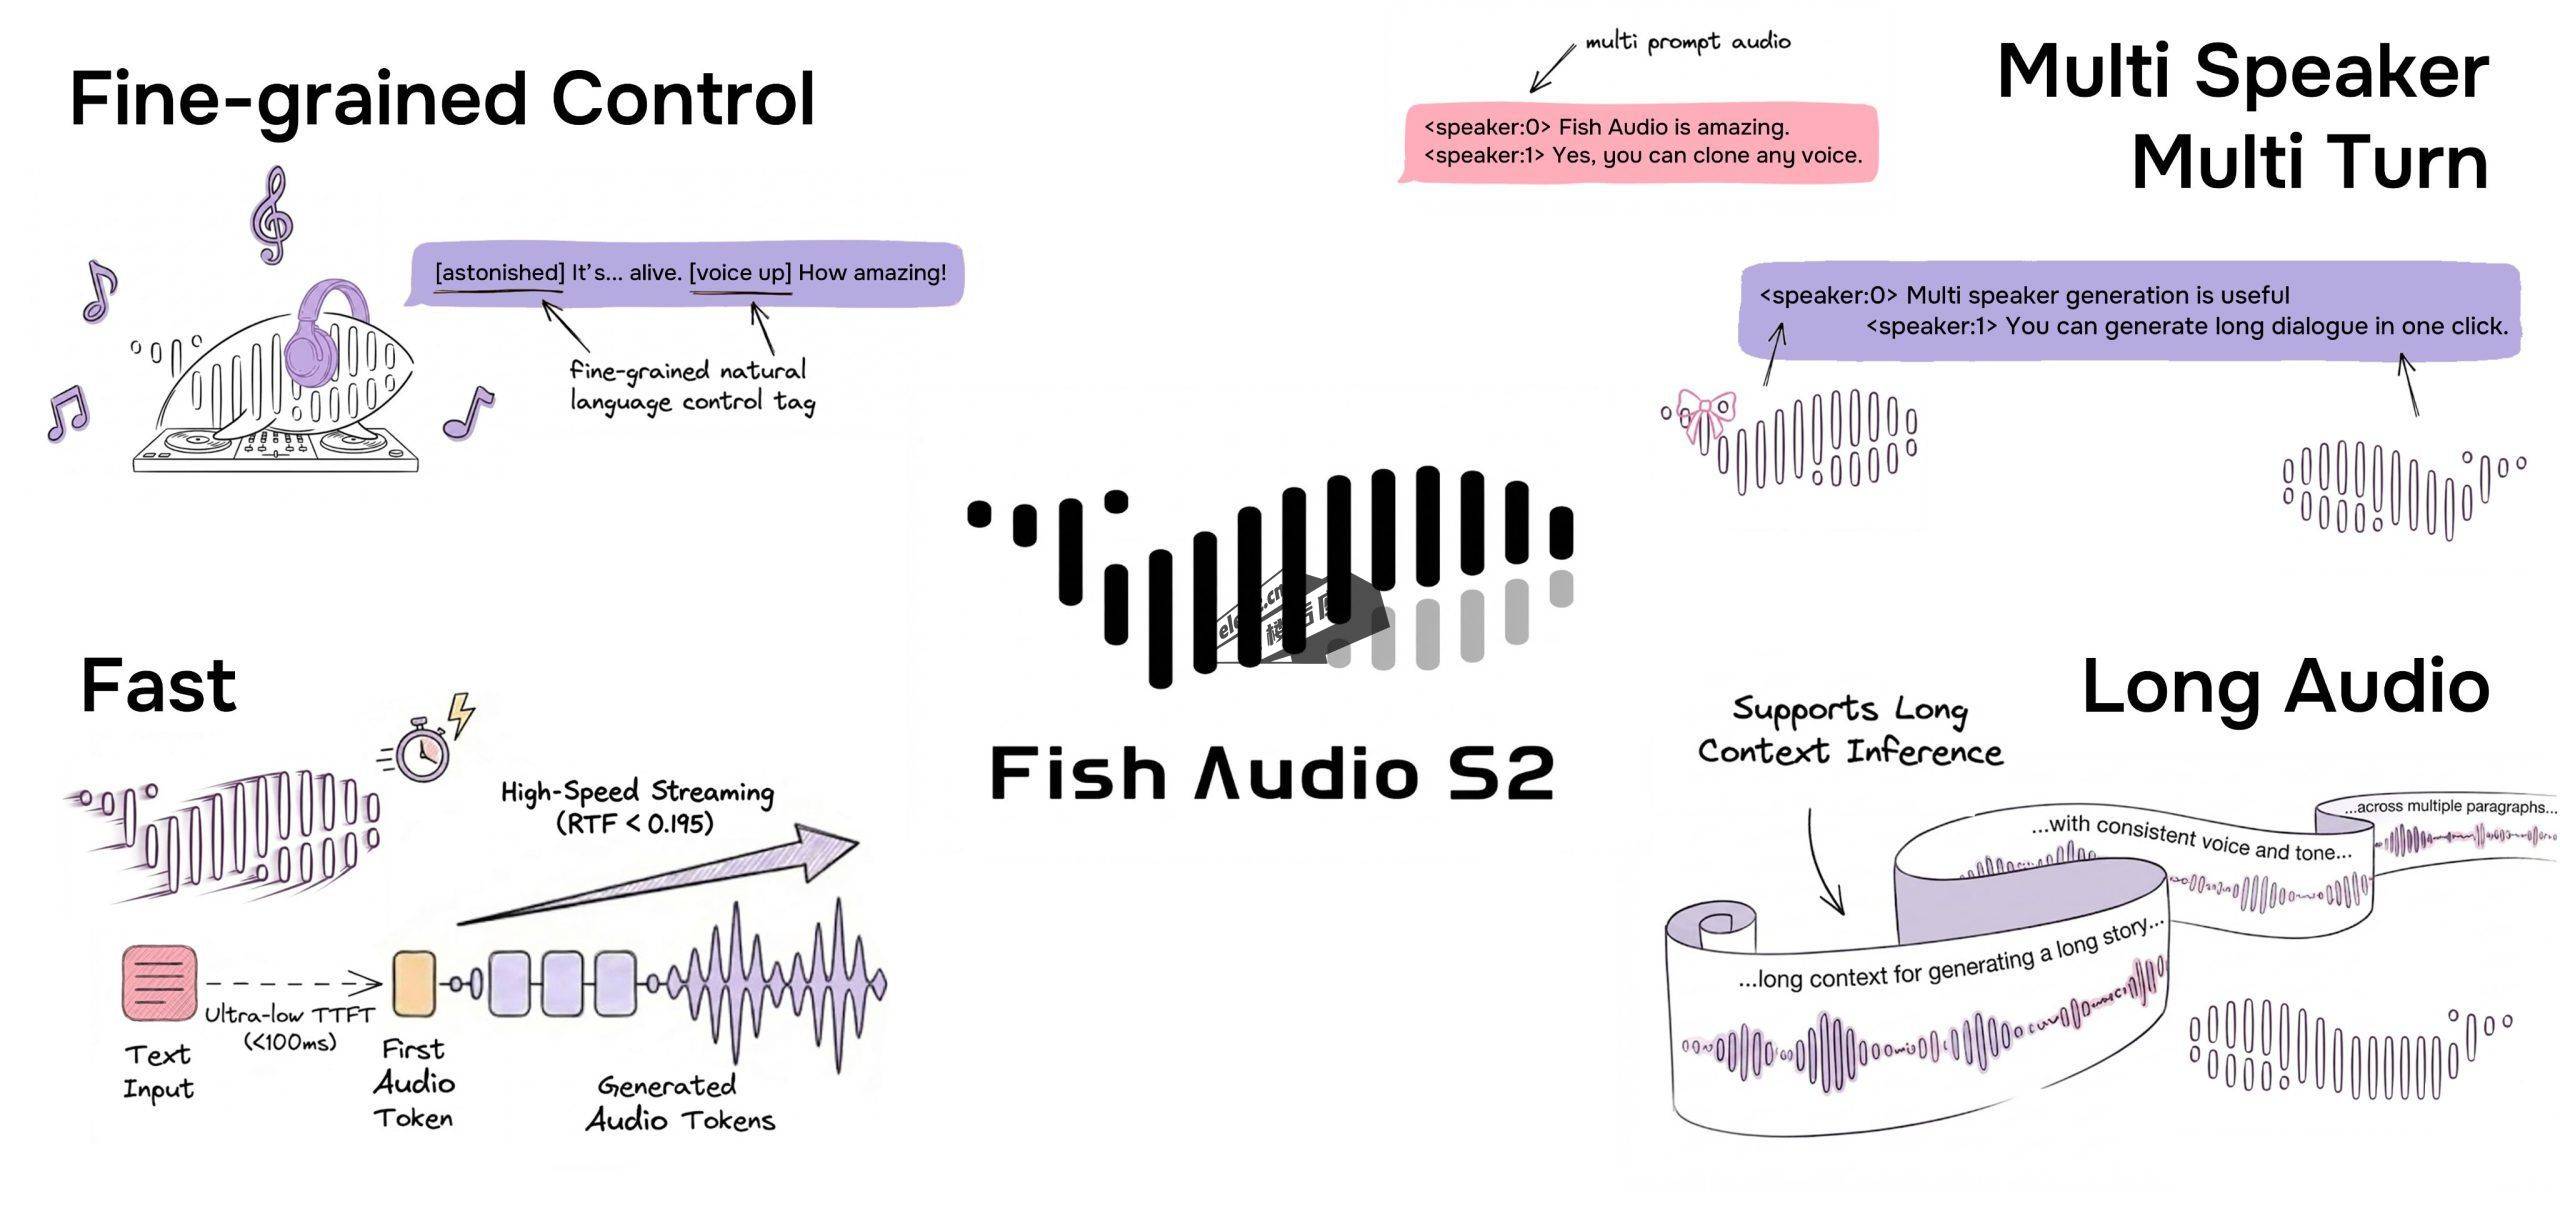
记得先 clone 仓库,再在目录里装;系统依赖是 apt install portaudio19-dev libsox-dev ffmpeg。Docker 版自带 WebUI,跑起来开 http://localhost:8080/ui。
真正劝退的在后面:官方文档写 Drama 3 至少 48GB 显存(FP8),只能 NVIDIA;S2-Pro 也要至少 24GB。对,48GB——这 10 个里吃显卡最狠的就是它。
许可小字,而且更绕:README 说代码和 Drama 3 走社区许可(年营收低于 50 万美元可以商用),S2-Pro 权重是研究许可;但 Hugging Face 上 Drama 3 标的也是 research license。两边说法对不上,商用前两边都确认一遍。
⑧ SoulX-Podcast:专做方言播客的多人对话
Soul AI Lab 开源,专门做播客式的多人、多轮对话。星数是这 10 个里最少的(3.6k),但如果要同时满足中文多人对话和权重能商用这两条,它最对口。
普通话、英语之外,还支持四川话、河南话、粤语,而且能拿普通话参考音零样本克隆出方言。笑声、叹气这些副语言直接写标签:<|laughter|>、<|sigh|>、<|breathing|>、<|coughing|>、<|throat_clearing|>。README 写得很明白:代码和模型权重都是 Apache 2.0。
官方试听:soul-ailab.github.io/soulx-podcast · 在线试玩:Hugging Face Spaces
git clone https://github.com/Soul-AILab/SoulX-Podcast.git
cd SoulX-Podcast
conda create -n soulxpodcast -y python=3.11
conda activate soulxpodcast
pip install -r requirements.txt
pip install -U huggingface_hub
huggingface-cli download --resume-download Soul-AILab/SoulX-Podcast-1.7B --local-dir pretrained_models/SoulX-Podcast-1.7B
python3 webui.py --model_path pretrained_models/SoulX-Podcast-1.7B
国内装依赖可以加 README 里的阿里云源 -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com。命令行直接出对话样例:bash example/infer_dialogue.sh。要方言就换成方言模型:
huggingface-cli download --resume-download Soul-AILab/SoulX-Podcast-1.7B-dialect --local-dir pretrained_models/SoulX-Podcast-1.7B-dialect
python3 webui.py --model_path pretrained_models/SoulX-Podcast-1.7B-dialect坑:README 里 clone 用的是 git@github.com: 的 SSH 地址,没配 SSH key 会直接失败,换成上面的 https 地址就行。安装说明只写了 Linux;流式推理还在 TODO 里没做完,想加速可以走 README 里的 vLLM Docker 方案;显存 README 没写。README 也写了:不许拿它做未经授权的声音克隆、冒充和诈骗——跟 VoxCPM 那条一样,是底线。
五、轻量 / 要实时(2 个)
⑨ Kokoro:只有 8200 万参数的小钢炮
只有 8200 万参数,权重 Apache,生产环境、个人项目都能部署。它是个轻量 TTS 推理库,英、西、法、印地、意、日、葡、中文都有(中文要额外装 misaki[zh])。批量出旁白、给小工具配个嗓子,都挺合适。Mac M 系列可以开 MPS 加速。
官方试听:Kokoro-82M SAMPLES
pip install -q kokoro>=0.9.4 soundfile
apt-get -qq -y install espeak-ng
from kokoro import KPipeline
import soundfile as sf
pipeline = KPipeline(lang_code='a')
for i, (gs, ps, audio) in enumerate(pipeline("Hello from Kokoro.", voice='af_heart')):
sf.write(f'{i}.wav', audio, 24000)
坑:不能克隆声音,只能用自带音色。lang_code 要和音色对上,不然发音会乱。依赖出问题就用 README 给的 conda environment.yml。另外仓库最近一次推送是 2025-08,介意更新频率的心里有个数。
⑩ VibeVoice:首包 200ms 级的实时旁白
微软开源。首包约 200–300 毫秒,可以边收文字边说话,适合给 Agent 接个嗓子。现在能用的是 VibeVoice-Realtime-0.5B:单说话人、流式输入、能连说约 10 分钟,另有 9 种实验性语言音色可以下。
官方项目页:microsoft.github.io/VibeVoice · Colab 笔记本
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice/
pip install -e .[streamingtts]
python demo/vibevoice_realtime_demo.py --model_path microsoft/VibeVoice-Realtime-0.5B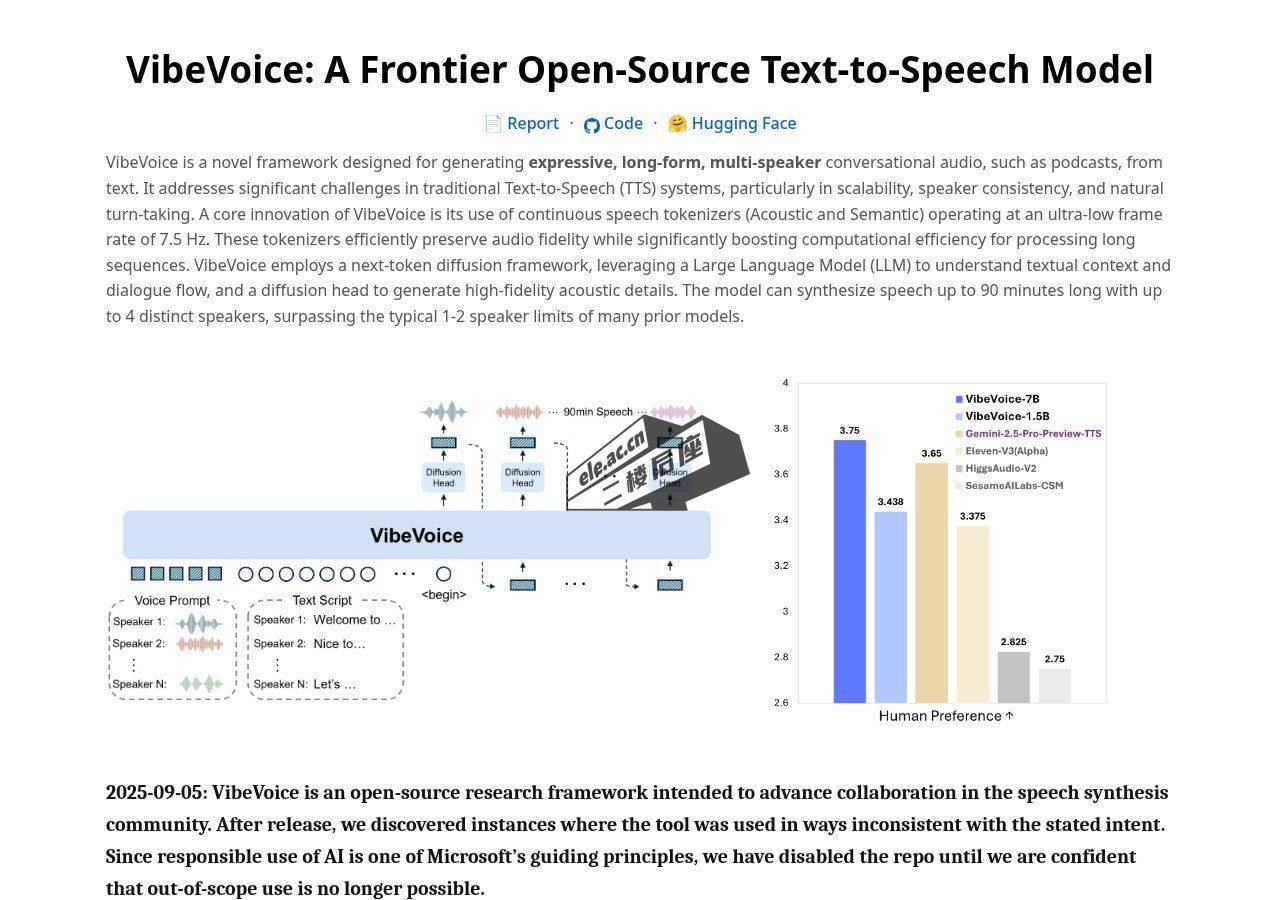
坑在这儿:你可能以为它就是那个「90 分钟、4 个人的播客版」。其实那个版本的 TTS 代码 2025-09 已经被微软撤下了,README 模型表里它的试用也标着 Disabled。现在这个 Realtime 版,官方说只面向英文,中文会出意外结果,也不能自己克隆音色。README 说不建议直接商用。模型 MIT。
硬件这块 README 说得很实在:官方只在 NVIDIA T4 和 Mac M4 Pro 上实测跑到过实时,比这两者弱的设备官方让「自己测」。它没给显存数字,所以别拿「没写」当「要求低」——T4 是 16GB 显存的卡,这个量级可以先当参考。
六、速查表:10 个工具一表对比
星数为 2026-10 核实的实测值;「显存 / 硬件」和「商用」两列直接照各仓库 README 与官方文档写,「README 未给」就是不写。
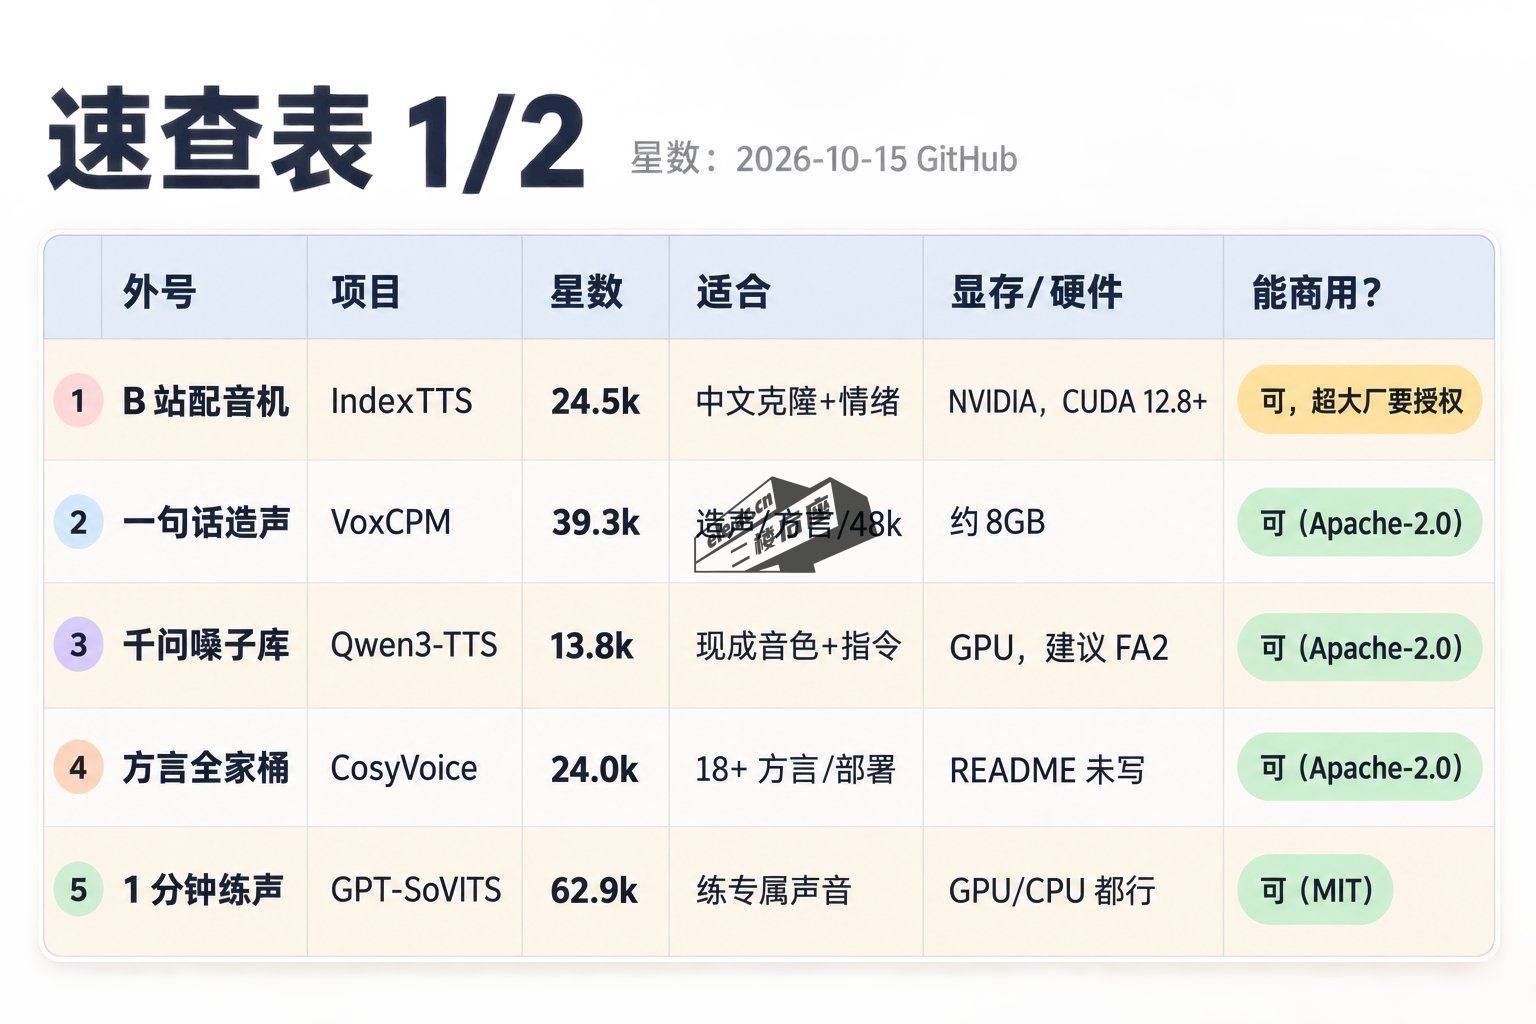
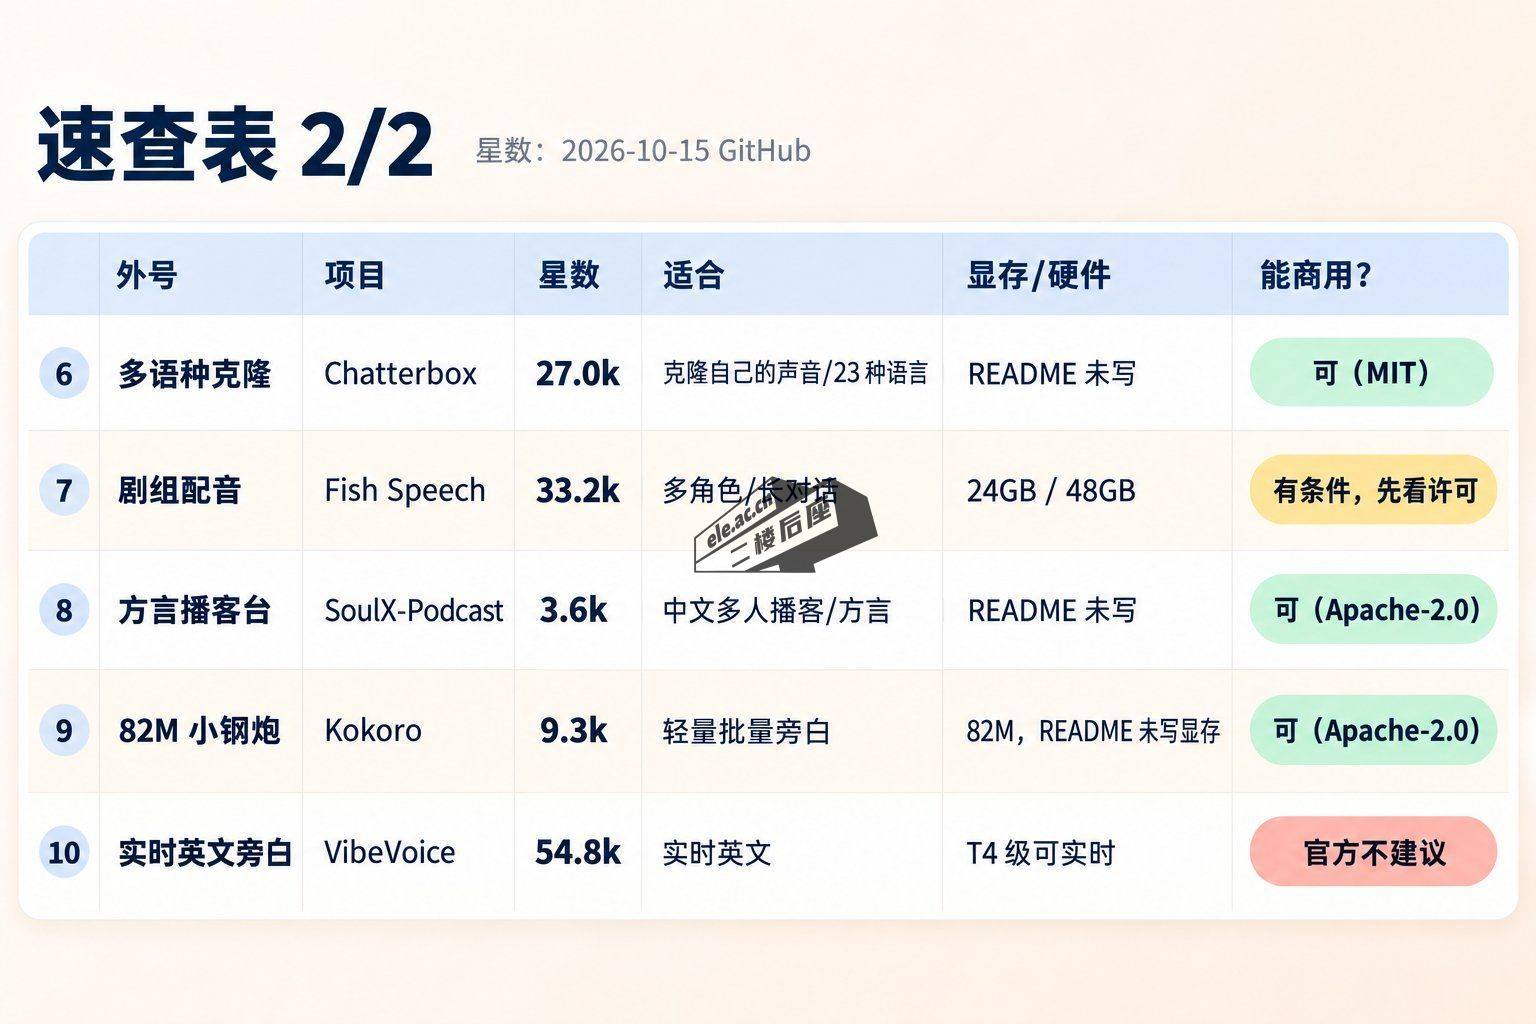
下面另附两张原版速查图,手机上想直接存图可以看这个(内容与下表一致)。
| 项目 | 星数 | 适合 | 显存 / 硬件 | 商用 |
|---|---|---|---|---|
| IndexTTS | 24.5k | 中文配音 + 情绪 | CUDA 12.8+ | 需申请(bilibili 协议) |
| VoxCPM2 | 39.4k | 造声 / 克隆 / 方言 | 约 8GB | 可(Apache-2.0) |
| Qwen3-TTS | 13.8k | 现成音色 + 克隆 | README 未给 | 可(Apache-2.0) |
| CosyVoice | 24.0k | 18+ 方言 | README 未给 | 可(Apache-2.0) |
| GPT-SoVITS | 62.9k | 练专属音色 | GPU / CPU 都行 | 可(MIT) |
| Chatterbox V3 | 27.0k | 多语种克隆 | README 未给 | 可(MIT) |
| Fish Speech | 33.2k | 多角色长对话 | 24GB / 48GB(FP8),仅 NVIDIA | 需确认(两边说法不一) |
| SoulX-Podcast | 3.6k | 方言播客对话 | README 未给 | 可(Apache-2.0) |
| Kokoro 82M | 9.4k | 轻量批量旁白 | README 未给(CPU 可跑) | 可(Apache-2.0) |
| VibeVoice-Realtime | 54.8k | 实时英文旁白 | README 未给显存(点名 T4 / M4 Pro 可实时) | 官方不建议直接商用 |
七、懒人版:把这段丢给 Agent
懒得一个个装?把下面这段整段复制给 Agent。它会先看你的机器跑得动哪些,再让你选,不会一口气全给你装上。
我要在本机挑几个开源 TTS 试配音。
先检查我的显卡型号、显存、CUDA 版本、Python/conda/uv,告诉我下面哪些跑得动,再让我选,别一次全装:
1. https://github.com/index-tts/index-tts (uv sync,下 IndexTTS-2.5)
2. https://github.com/OpenBMB/VoxCPM (pip install voxcpm)
3. https://github.com/QwenLM/Qwen3-TTS (pip install -U qwen-tts)
4. https://github.com/QwenAudio/CosyVoice (clone --recursive)
5. https://github.com/RVC-Boss/GPT-SoVITS (install.sh)
6. https://github.com/resemble-ai/chatterbox (pip install chatterbox-tts,中文用 Multilingual V3)
7. https://speech.fish.audio/install/ (Fish Speech,S2-Pro 要 24GB 显存)
8. https://github.com/Soul-AILab/SoulX-Podcast (clone 用 https 地址,下 SoulX-Podcast-1.7B)
9. https://github.com/hexgrad/kokoro (pip install kokoro)
10. https://github.com/microsoft/VibeVoice (只装 Realtime-0.5B)
每个都严格按各自 README 装,各用独立环境,装完用同一句中文测试稿各出一条音频给我对比(VibeVoice 只支持英文,用英文句)。
八、商用前,先看许可小字
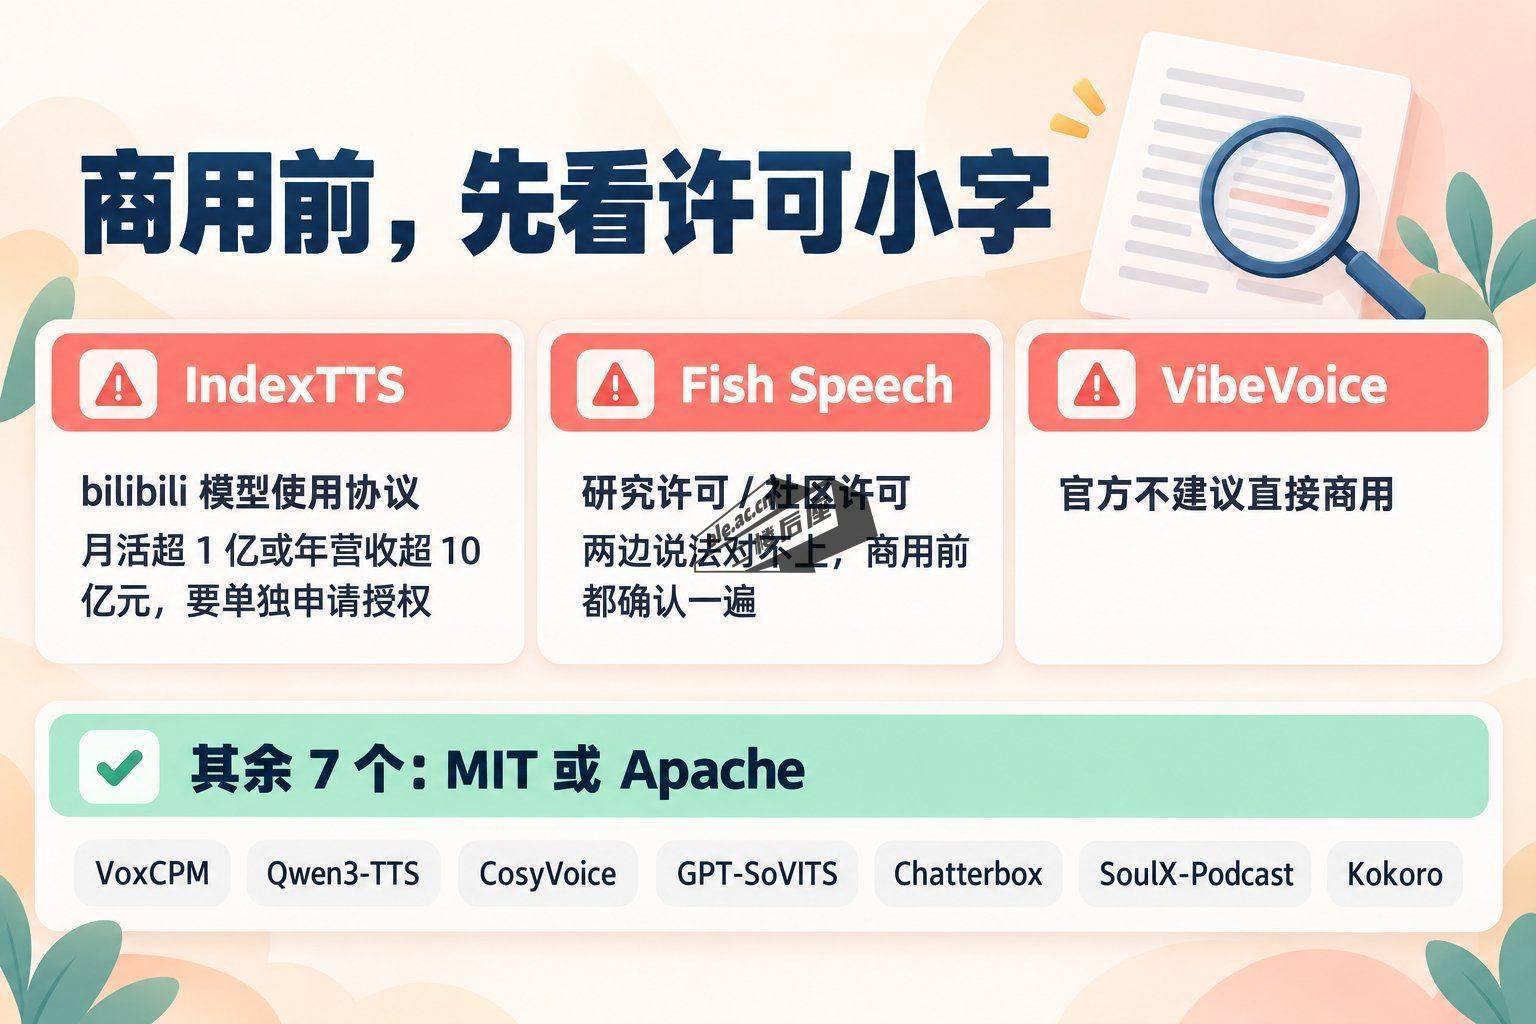
许可证这个东西有点像租房合同里的小字:平时没人看,出事的时候每一行都算数。这 10 个里,有 3 个不能直接拿去商用:
| 项目 | 要留意什么 |
|---|---|
| IndexTTS | 走 bilibili 模型使用协议,不是 Apache;月活超 1 亿或年营收超 10 亿元需单独申请授权 |
| Fish Speech | 研究许可 / 社区许可两种说法,仓库与 Hugging Face 标注不一致,商用前两边都确认 |
| VibeVoice | 官方明确写「不建议直接商用」 |
剩下 7 个(VoxCPM、Qwen3-TTS、CosyVoice、GPT-SoVITS、Chatterbox、SoulX-Podcast、Kokoro)都是 MIT 或 Apache-2.0,这一类在商用上通常不用太纠结。
九、安装前值得知道的三件事
| 容易踩的坑 | 实际情况 |
|---|---|
| 一口气全装 | 十个项目依赖互相打架(torch 版本、CUDA 版本各不相同)。每个都用独立 conda 环境,别图省事共用 |
| 只看星数选型 | 62.9k 的 GPT-SoVITS 适合练音色,48GB 门槛的 Fish Speech 才能演多人剧。星数只说明关注度,不说明适配度 |
| 不看 README 的「未给」 | 好几个项目压根没写显存要求。「没写」不等于「要求低」,先跑仓库里的 gpu_check 类脚本再下权重 |
还有一点值得说清楚:别追求「装得多」,要追求「用透一个」。先想清楚自己要的是中文配音、练自己的声音、多人对话,还是实时,然后只挑一组,把这一组里的一个跑顺、调好参数、接进你自己的工作流。剩下的九个,等你真的遇到新场景再回来看。
站内相关
- 即梦 AI 提示词视频课:从写提示词到出片 —— 配音是视频流水线的一环,这篇讲前面那半段
- Pixelle-Video:把素材自动剪成视频 —— 有了配音之后,下一步是让视频自己拼起来
- Obsidian + Claude Code:把工作流沉淀下来 —— 十个工具试完,总得有地方记结论






暂无评论内容