
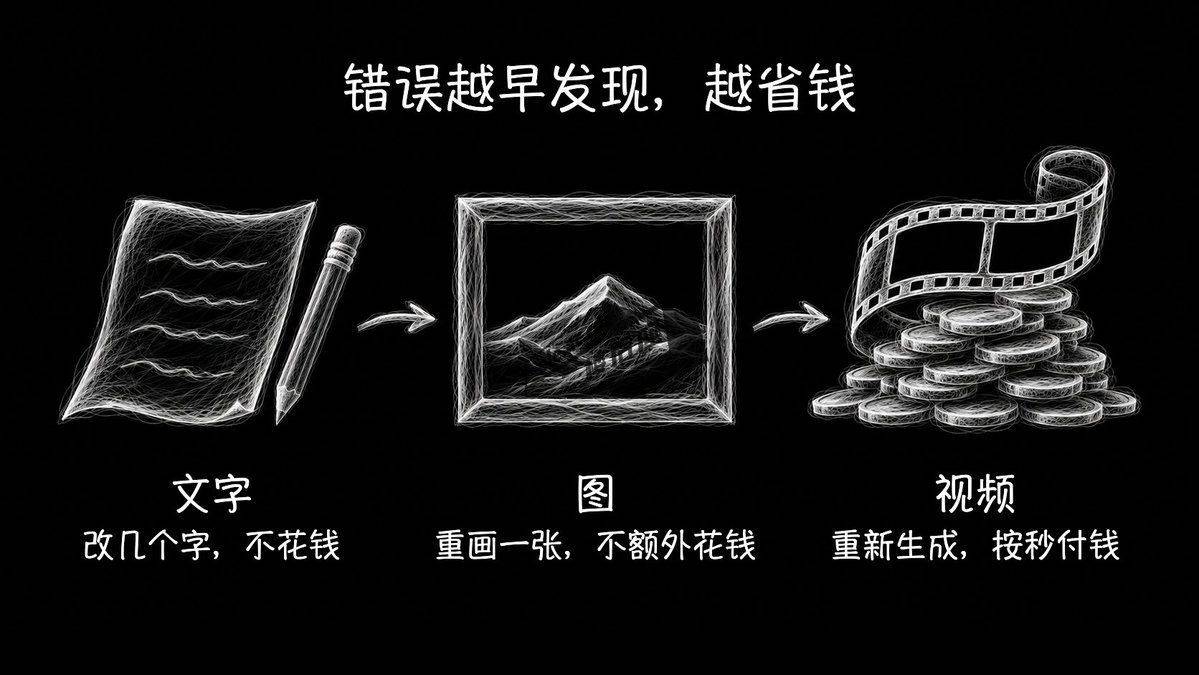
几秒钟的视频,重抽一次就按秒再付一次钱。真正省钱的办法不是少点几次生成,而是把错误提前挡在文字和图片阶段。
本文有什么:①3 个模型的分工与接入方法;②可直接复制的导演、故事、分镜、审核提示词;③从想法、剧情、分镜、画风、首尾帧到生成视频的完整步骤;④一张模型常见错误对照表。预计阅读 13 分钟,建议先收藏再跟着做。
一、工具层:只和总导演沟通
结论:全程只和 Claude Code 沟通,其余模型由它调用,不用切窗口、来回复制粘贴。
一共用到 3 个模型,外加 2 个工具:ffmpeg 和 Python。
| 角色 | 负责什么 |
|---|---|
| 我 | 选方向、确认画风、批准花钱;看动态、听声音 |
| Claude(导演) | 写故事和分镜,写所有提示词,检查每张图和每段视频,写代码做后期 |
| Codex(画师) | 画设定图、样帧和每个镜头的首尾帧 |
| Seedance(动画师) | 把首尾帧变成几秒钟的视频 |
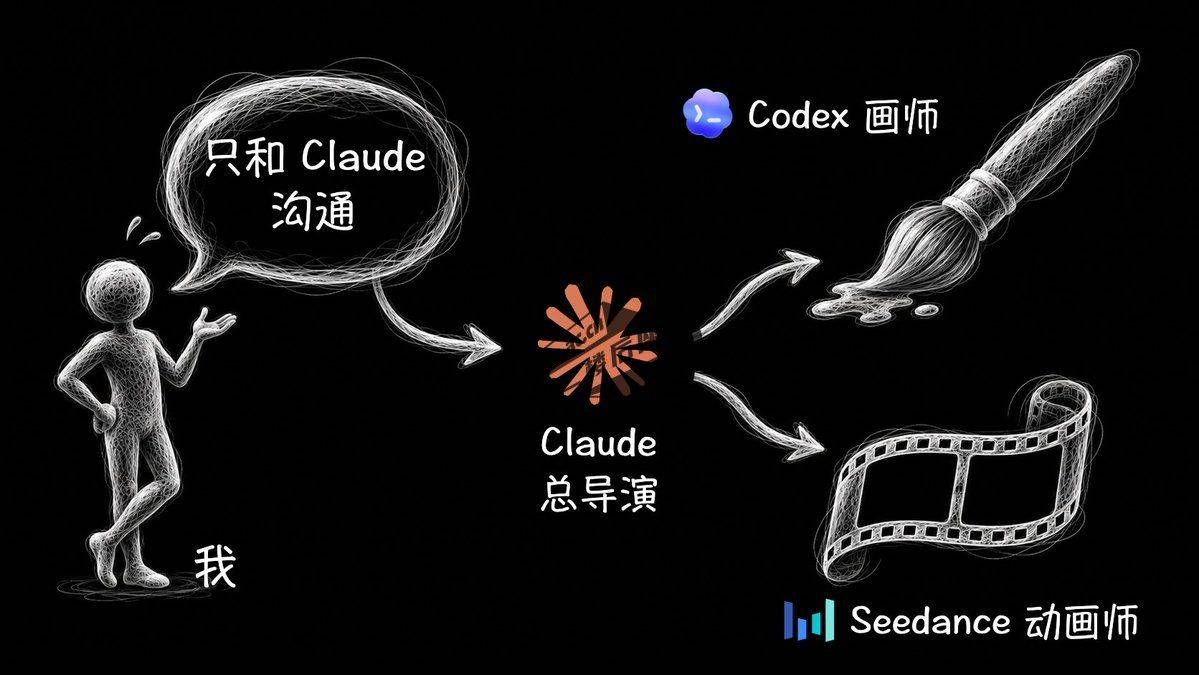
上图对应这套多模型分工:导演统筹,画师出图,动画师只负责最后的动态生成。
暂时没有 Claude Code,也可以用 Codex 代替,活都能干;使用体验上 Claude 更聪明一点、审美高一些。
1. 怎么接入
电脑上本来就装有 Claude Code 和 Codex,直接告诉 Claude:图片调用 Codex 生成。
Seedance 的接入分三步:去火山引擎注册账号 → 申请 API Key → 让 Claude 按要求填好 Key、把该写的脚本写好,剩下的由它处理。
核心原则只有一句:能在文字里发现的错,不留到图上;能在图上发现的错,不留到视频上。改提示词只改几个字,重画一张图不额外花视频的钱,重新生成视频却要按秒付钱。
2. 开工前发给 Claude/Codex 的导演提示词
做视频前,先把下面这段完整发过去:
你当这支短片的总导演,全程负责,我只和你沟通。
开工前先做两件事:1. 问我:片长、画幅、总预算、要不要配乐和字幕。2. 检查 Codex、ffmpeg、Python 和 ARK_API_KEY 能不能用,缺什么告诉我。
记住所有文件都放在一个新的项目文件夹里。
分工:你写故事和分镜,写所有提示词,调用其他模型,抽帧放大检查每张图和每段视频,用 ffmpeg 和 Python 写代码做后期。Codex(画师)画设定图、样帧和每个镜头的首尾帧,你不自己画;如果你就是 Codex,就用你自己的生图工具。Seedance(动画师)把首尾帧变成几秒钟的视频。我选方向、确认画风、批准花钱、看动态、听声音。
调用 Codex:
codex exec --skip-git-repo-check -s read-only -i 参考图.png - < 提示词.txt。提示词开头写:Use your image generation tool to create exactly ONE image. Do not run shell commands. 画好的图在~/.codex/generated_images/<日志里的 session id>/。调用 Seedance:POST
https://ark.cn-beijing.volces.com/api/v3/contents/generations/tasks,Key 在环境变量 ARK_API_KEY 里,不要打印出来。请求格式查火山方舟文档。模型选 doubao-seedance-2-5-260628(720p 约 ¥1.5/秒)或 doubao-seedance-2-0-mini-260615(720p 约 ¥0.5/秒),价格以账单为准。总原则:把错误挡在花钱之前。文字里能发现的错,不留到图上;图上能发现的错,不留到视频上。
规矩:1. 我确认故事前,不画任何图。2. 我确认画风前,不画正式镜头。3. 提交视频生成前,另开一个 agent 审核提示词和图片的每个细节,它只挑错,不改文件。通过后报价,我同意才提交。4. 视频有问题,先想能不能用代码修,修不了才重拍,只拍这一镜。5. 新版本存新文件,不覆盖、不删除旧文件。6. 你看不到真正的动态,也听不到声音。没看过、没听过的东西,要明确告诉我。7. 不充值,不买额度。接口返回欠费就停,把已有的片段先粗剪给我看。
二、实操层第 1 步:从一个想法到完整剧情
结论:先把初步想法讲给 AI,不用太详细,边聊边完善,定稿后还要换一个新 agent 审核。
一个完整的好故事,要过 5 关:
1.1 符合现实逻辑。每个转折都追问一遍:为什么会这样?东西从哪来?够得着吗?现实里真会这样吗?除非这支片子本来就不考虑现实逻辑。
1.2 一句话说清想表达什么。再问:剧情哪些地方设计得最好?自己都说不出来,剧情大概率很平淡,继续改。
1.3 开头就要抓人。看几秒就可能划走,最抓眼球的画面要放在前面。
1.4 旁人的反应要像真人。每个包袱或转折分 3 段写:问题 → 主角怎么解决 → 旁人什么反应。反应要有先后,不能几个人同一秒举手;细节也要真,比如人吃惊时身体会往后缩。
1.5 剧情要 AI 拍得出来。写故事时就避开这些固定弱点:人物交叉、手拿小东西、文字、镜子和倒影、左右不对称的特征、一镜内换光、一人连做三个动作、俯拍看不到脸、配角太多。
故事结构首选片段式:每个镜头之间不用接戏,最稳。连贯式最容易穿帮,要格外注意片段之间的连接。
可复制的故事提示词
我想做的片子:[一句话,或者我的初步剧情]。片长:[秒]。配歌:[歌名、时长、BPM;不配歌就删掉]。参考片:[有就写,没有就删掉]。
先帮我把这个想法完善成一个完整的故事。有不清楚的地方就问我,我们一起聊,等我确认了再往下写。故事结构首选片段式,因为每个镜头之间都不用接戏,最稳。连贯式最容易穿帮,除非我要求,否则不要用。
故事确定以后,展开成逐镜头的故事,要满足:1. 符合现实逻辑,每个转折按现实追问。2. 能用一句话说清想表达什么,先把这句话写出来,说不出来就说明故事还要改。3. 开头抓人,最抓眼球的画面放在前面,写清楚第几秒出现什么。4. 每个包袱或转折分 3 段:问题 → 主角怎么解决 → 旁人什么反应;反应要有先后,细节真实。5. 避开 AI 弱点:人物交叉、手拿小东西、文字、镜子和倒影、左右不对称的特征、一个镜头里换光、一个人连做三个动作、俯拍看不到脸、配角太多。如果配歌,转折对副歌,关键动作对重拍。
用新 agent 审故事
定稿还不能往下走。对 Claude 说一句“新开一个 agent 来审这个故事”,只给它定稿故事,其他文件都不给。
原因很实际:主 agent 和你聊了很久,看故事时会自动脑补;新 agent 什么都不知道,像第一次看片的观众,哪里看不懂,哪里就真的没讲清楚。后面几步的审核同理:只给材料,不给结论。
这是一支短片的逐镜头故事。你是第一次看,只负责挑错,不改文件。1. 只按镜头顺序读,先写出你看懂的故事。2. 按顺序追问每个转折:为什么会这样?东西从哪来?够得着吗?现实里真会这样吗?3. 能用一句话说清想表达什么吗?4. 开头抓人吗?最抓眼球的画面放在前面了吗?5. 旁人的反应像真人吗?有没有先后?6. 哪些镜头 AI 视频模型容易拍错?(人物交叉、手拿小东西、文字、镜子和倒影、左右不对称的特征、一个镜头里换光、一个人连做三个动作、俯拍看不到脸、配角太多)每条写:镜头、问题、建议改法。没把握的写“可能”。最后写“通过”或“不通过”。
三、实操层第 2 步:分镜,定镜头语言、构图和配色
结论:这是前期最重要的一步,甚至构图和配色比剧情更决定画面质感。故事再好,镜头没设计好,画面就会平淡。
镜头语言说不清怎么办?最有效的是找参考片,让 Claude 逐帧看,把机位、进出画比例都量出来,再学习模仿。没有参考片,就按下面 6 条构思。
每个镜头都要写清:景别、机位、运镜、谁往哪走(写画面左右)、靠什么表情推进、怎么转到下一镜。
2.1 每镜换角度。全片平视正面最多两次,其余用俯拍、仰拍、从背后、过肩、透过东西拍。机位越多,画面越丰富。
2.2 画面里要一直有东西在动。大多数镜头要有人或东西走进画面、或走出画面。人不走动,比如一直坐着,就让别的东西动:飘过去的一张纸、身后走过的路人。固定机位很难用、容易呆板,更要让人在画面里走动,比如从远处走到近处。也不要连着几个镜头都是同样大小:全身、半身、脸部特写换着来。
2.3 写清具体是什么在运动。摄影机、焦点从一个人换到另一个人、光线、镜头前飘过的东西、人物的小动作(如手在抖),至少要有一样;一样都写不出来,说明镜头还没想好。但也不是一直动,该动则动、该静则静,才有对比。
2.4 镜头运动要有理由。只用三种常用法:跟着一个东西或人物走;慢慢推近给特写;一开始拍得很近,再慢慢拉远。
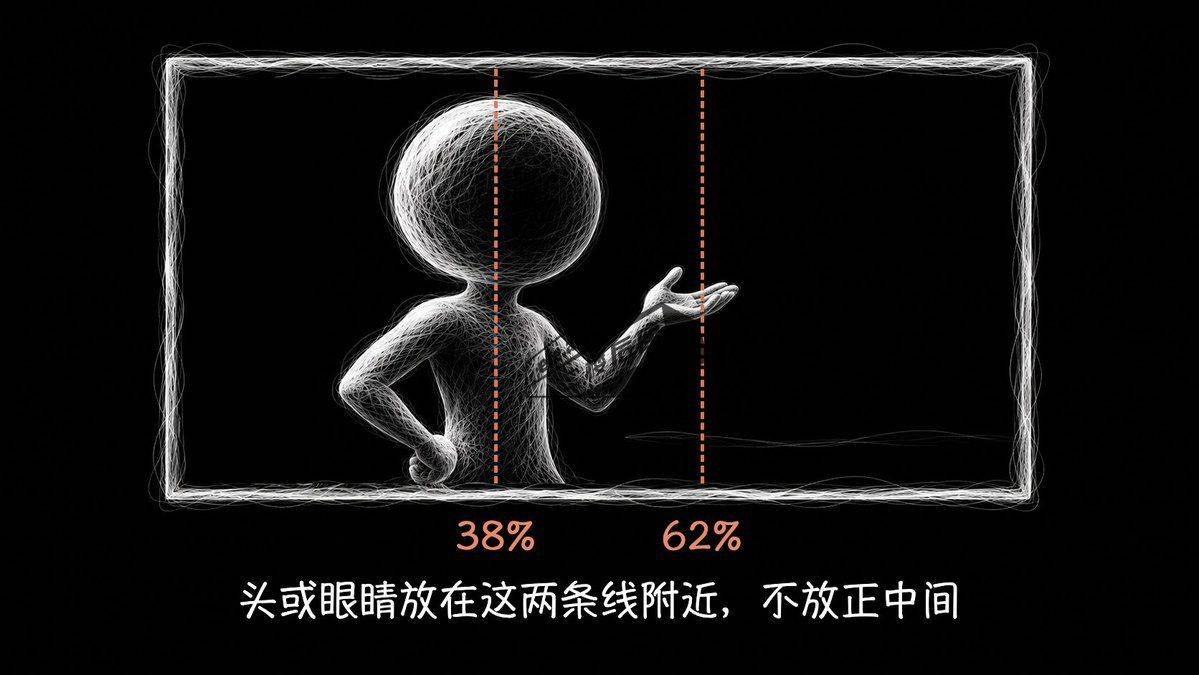
2.5 每一秒截图都要好看。用黄金比例构图:人的头或眼睛落在画面从左往右约 38% 或 62% 的位置,不放正中间。
2.6 配色单独设计。画第一张图之前就定好,不交给模型发挥。再让 Claude 把每一场用什么颜色单独列成一张色表;最后把画面转成黑白看一遍,人和背景区分不开,说明明暗对比不明显,要重调配色。
分镜阶段先把机位、运动和构图定死,后面的首尾帧和视频都只按这张表执行。
可复制的分镜提示词
把定稿的故事写成分镜表。每个镜头一行,写清楚:片中时间(配歌就按小节算)、生成秒数(片中时长向上取整,尽量多留 0.5 秒)、景别、机位、运镜、谁往哪走(写画面的左右)、靠什么表情推进、这个镜头是什么在动、怎么转到下一个镜头。
如果有参考片,先逐帧看参考片,把机位、进出画比例这些都量出来,然后学习模仿。没有参考片就按要求构思:1. 每个镜头换角度,全片平视正面最多两次,其余用俯拍、仰拍、从背后、过肩、透过东西拍。2. 画面里要一直有东西在动;人不走动就让别的东西动;固定机位更要让人在画面里走动。3. 不要连着几个镜头都是一样大小的画面,全身、半身、脸部特写换着来。4. 每个镜头写清是什么在动,至少一样,也不要一直动。5. 镜头运动要有理由:跟着走、推近给特写、或从近慢慢拉远。6. 每一秒截图都要好看,头或眼睛落在约 38% 或 62% 的位置。
配色单独设计,在画第一张图之前定好。我想要的配色:[我的喜好;没想好就给我几个方案选]。把每一场用什么颜色单独列成一张色表。最后用代码给每个镜头画一张 1920×1080 的色块草图,标出 38% 和 62% 的位置和主要的东西,拼成一张总表给我确认。再把草图转成黑白看一遍,人和背景区分不开就重新调配色。
四、实操层第 3 步:定画风,画设定图
结论:画风先定,人物长相再定,后面所有镜头才不会每张一个样。
画风就是绘画风格,比如手绘、柔和、颜色温暖,或线条简单像剪纸,或写实得像照片,或手绘线条感的美国动画。有参考图最好,直接发给 AI。
这一步 Claude 写提示词,Codex 画,你只负责看是不是想要的风格。
画风定下后,给每个角色和固定道具画设定图:一般是正面、侧面和几个表情,相当于把长相定下来。人物身上固定的东西一定要写清位置,比如纹身在左手臂上,否则后面每张图位置都可能不一样。
五、实操层第 4 步:出每个镜头的首尾帧
结论:这是降低抽卡率最关键的一步。首尾帧就是一个镜头的第一张和最后一张画面。
只靠文字生成视频,模型容易出逻辑错误;雨、帽子、纹身只写在文字里,拍着拍着就会消失,必须在首帧和尾帧都画上才稳。
画的顺序也有讲究:
- 不要一上来就开画。先让 AI 写清每个镜头的首帧画什么、尾帧画什么、中间发生什么,让审核 agent 审过再画,省 Codex 额度。
- 先画内容最多的那张,一般是尾帧,再在尾帧上改出首帧,保证两张图的摄影机位置和构图一致。
- 同一地点、同一机位的镜头,直接在前一张图上改,不重新画,Codex 支持图片的局部改动。
- 运镜是慢慢推近时,尾帧直接把首帧裁一块放大;首尾帧构图完全一样,镜头就等于不动,生成不出推进效果。
- Codex 出的图不一定正好是 16:9,提交 Seedance 前检查,有问题提前裁好,首帧和尾帧尺寸保持一样。
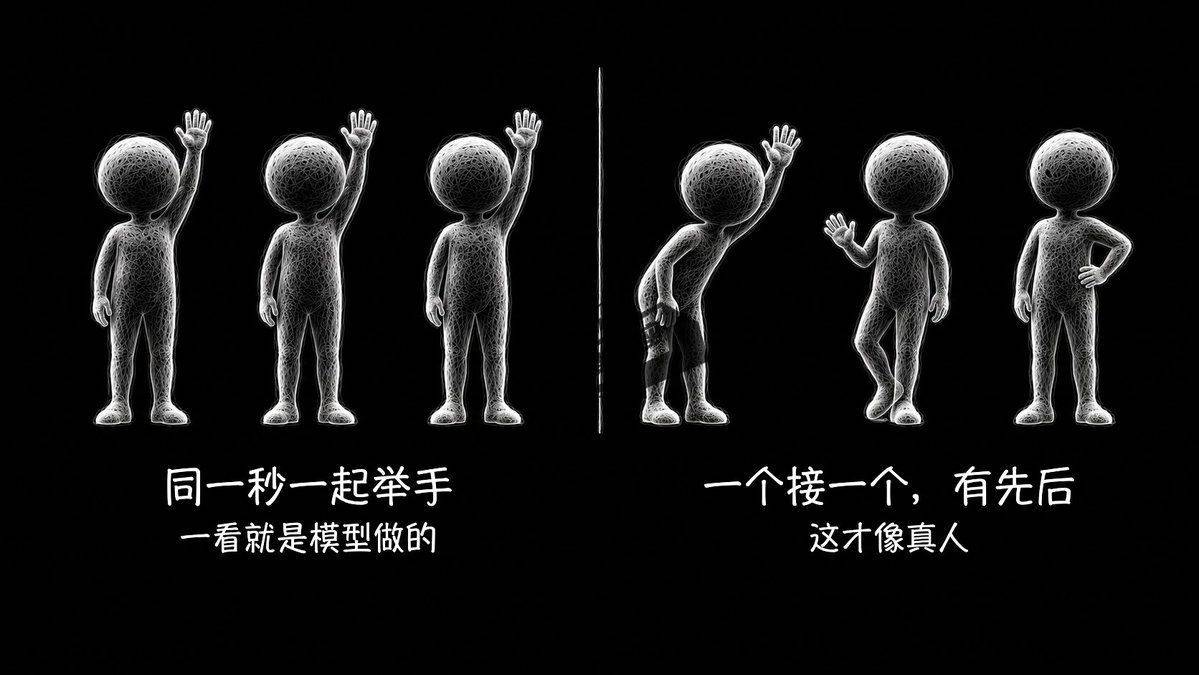
首尾帧要成对看:机位、构图、道具位置对不上,到了视频里就会慢慢变形。
首尾帧检查提示词
首尾帧画完了,帮我按下面逐条检查,每张图都要放大看。有问题就告诉我是哪张图、哪里不对,我同意了再改。材料:[首帧]、[尾帧]、[设定图]、[这个镜头的分镜]。
- 动作要用到的东西,首帧里必须有。比如后面要拿杯子,首帧里就要看得到杯子,否则杯子会凭空冒出来。2. 别人的反应要提前摆好。一个镜头没法中途切过去拍别人,所以首帧里安排好:一个人在前面做事,另一个人在后面,脸朝着镜头。3. 很多人一起出现时,不能摆同一个姿势,不然模型会让所有人同时动。4. 给动作留出空间。东西要落到、飘到的地方提前空出来,头顶也要留空。5. 风向统一,不能围巾往左飘、床单却往右飘。6. 缩小到手机大小看一遍,远处的人太小、看不清就改。7. 放大看有没有多余的东西,比如多一个水壶、多一条奇怪的细线。8. 把首帧和尾帧叠在一起看有没有错位。不该变的地方两张图必须一样:墙的颜色不一样,视频里墙就会慢慢变色;杯子大了一点,视频里杯子就会慢慢变大。
改图注意两点:Codex 就算只改一小块,也会把整张图重新处理一遍,所以只改一小块时,要把改好的那一块贴回原图;Codex 额度用完了就等它恢复,不要买额度,也不要一次同时画太多张。
六、实操层第 5 步:七段式视频提示词,提交前审核
结论:出了问题先怀疑提示词,再怀疑模型。提示词写得越细,抽卡越少。
固定用七段式,把每一秒发生什么都写下来:
[一句话写画风,比如:干净的现代 2D 手绘动画,平涂色块,线条利落,没有颗粒和纹理]。整段的画风、颜色、人物设计与首帧和尾帧完全一致。
整段 [X] 秒,[景别],[机位],[运镜;不动就写“不推不拉不摇,不切镜”]。
[人和东西在画面哪里,墙和光是什么颜色,要和首帧对得上]
[每个人的长相、衣服、固定道具,写死]
0–0.2 秒:画面完全静止,和首帧一模一样。[每一段:谁做什么,表情怎么变,手放在哪、不能碰什么,往画面哪边] 最后 0.3 秒:所有人完全停住,画面与尾帧完全一致。
只有 [看得见原因的声音]。人物不说话。
画面里一直只有首帧这几个人和这些东西,脸和身形全程不变,一镜到底。画面干干净净,没有文字、字幕、水印。
模型常见错误对照表:写提示词时逐条查
| 容易犯的错 | 应该怎么写/怎么处理 |
|---|---|
| 一群人同时做同一个动作 | 写清先后:“老爸第一个……过一两秒老奶奶才……小女孩最后……”;首帧也不要摆同一姿势 |
| 本该风做的事,人自己动手了,如邮差用手掀开邮包 | 写清原因,再写“两只手从头到尾都没有碰邮包” |
| 云、月亮、植物长出眼睛和嘴巴 | 不写“卡通云”,写“蓬松的灰白色积云,只有棉絮一样的纹理和阴影”,动作只写它怎么移动 |
| 人往反方向走 | 按画面写:“朝画面左边走,跨过左边的店门” |
| 一句话有两种意思,如“窗户后面的老人”让车里冒出人 | 写具体:“左上角石头房子的窗口里”,再加“驾驶座一直空着” |
| 东西的数量变了 | 把数量写出来:“只有一封黄信封,之后他怀里全是白信封” |
| 写“不要怎么样”没用,如“壶嘴不出水”还是出水 | 改成正面说法:“画面里一直只有首帧这几个人” |
| 模型会自己联想道具用法,如壶总是出水 | 干脆不让这个道具出现在有动作的镜头里 |
| 东西凭空出现 | 只用首帧里已经有的东西 |
| 东西突然飞走或瞬间移动 | 写清怎么动:“顺着后脑勺往后一滑,接住,扣回头上” |
| 雨、帽子、纹身拍着拍着没了 | 首帧和尾帧都画上 |
| 闪电画得太写实 | 写“云里闪一下白光”,再把开头剪掉 |
| 一个镜头动作太多就乱了 | 每个镜头只写一两个主要动作 |
| 动作时间和写的不一样 | 写的时间只能算大概,多留一点,后期用剪辑和变速对上节拍 |
| 镜头推得没写的那么明显 | 后期让 Claude 用代码再推一点 |
| 人的嘴自己在动 | 写明“人物不说话”,还动就用代码修 |
| 写了“没有音乐”还是混进音乐(Seedance 2.5) | 片段自带的声音不用,后期另外加 |
| 结尾几帧突然跳到尾帧的样子(Seedance 2.5) | 后期选一张没问题的画面,后面都停在这一张 |
| 第一张画面特别锐(Seedance 2.5) | 直接把这一张去掉 |
| 视频越到后面越暗越冷(Seedance 2.0 mini) | 每条视频都按它自己的首帧把颜色调回来 |
提交前再开一个 agent 审核
每条视频提交前,另开一个 agent,把提示词和图片逐个细节核对,通过后才提交。这一步曾查出:两张图里的杯子大小差了 13%、帽檐一张有一张没有、左右写反了。
你是审核,只读不改。这个镜头马上要提交视频生成,花的是真钱。材料:[提示词文件]、[首帧]、[尾帧]、[设定图]、[分镜表]、[配色规则]。逐项核对,放大看图:1. 提示词的每句话和两张图对得上吗?(位置、左右、颜色、人数、道具数量、衣服、表情)2. 两张图的机位、大小、背景一致吗?3. 和设定图、配色规则、前后镜头对得上吗?4. 动作现实吗?每个动作的原因写了吗?手放在哪?5. 模型可能在哪里出错?(同时动作、凭空出现、长脸、走反方向、歧义词)最后只写“通过”或“不通过”。不通过就逐条列出要改什么。
七、实操层第 6 步:生成视频与省钱技巧
结论:这一步基本由 AI 自动完成,人要管的是生成规格和试错顺序。
- 用 720p 生成,后期再放大到 1080p。
- 不用专门拍测试片,直接拍第一个正式镜头,能用就赚了。
- 新的做法先拿一两个最难的镜头试,行得通再全部提交。
走到生成这一步,前面的文字、图和审核做得越细,这里返工就越少。
记住整套流程的顺序:想法 → 完整剧情 → 新 agent 审故事 → 分镜与配色 → 画风与设定图 → 首尾帧与检查 → 七段式提示词 → 提交前审核 → 生成。顺序反了,钱就花在返工上。
来源:本文整理自 Eian《Claude code/Codex+Seedance AI视频:从一个想法到成片的全流程》(X 长文,2026-11-05),正文链接为原文提供的火山方舟 Seedance API 地址。





暂无评论内容