

先说一件事:这条被当成「Claude AI 完整课程」疯传的 2 小时视频,不是课程,也不是 Claude 的教程。它是斯坦福 CS229(机器学习)2024 年暑期课的一场特邀讲座,题目是 Building Large Language Models,主讲人是 Yann Dubois——Percy Liang 与 Tatsunori Hashimoto 指导的博士生、Alpaca 团队成员。视频里 Claude 只是作为聊天机器人的例子被提了一下。
但内容本身值得看。讲者一上来就说:Transformer 架构的讲解网上已经太多了,所以他这节课完全不讲架构,只讲剩下的四件事——评测、数据、算力成本和系统工程。而这四件事,恰恰是「为什么有的模型好用、有的不好用」的真正分水岭。
下面按讲座顺序,把关键信息点全部拆出来。
一、这场讲座的核心结论:架构被高估了
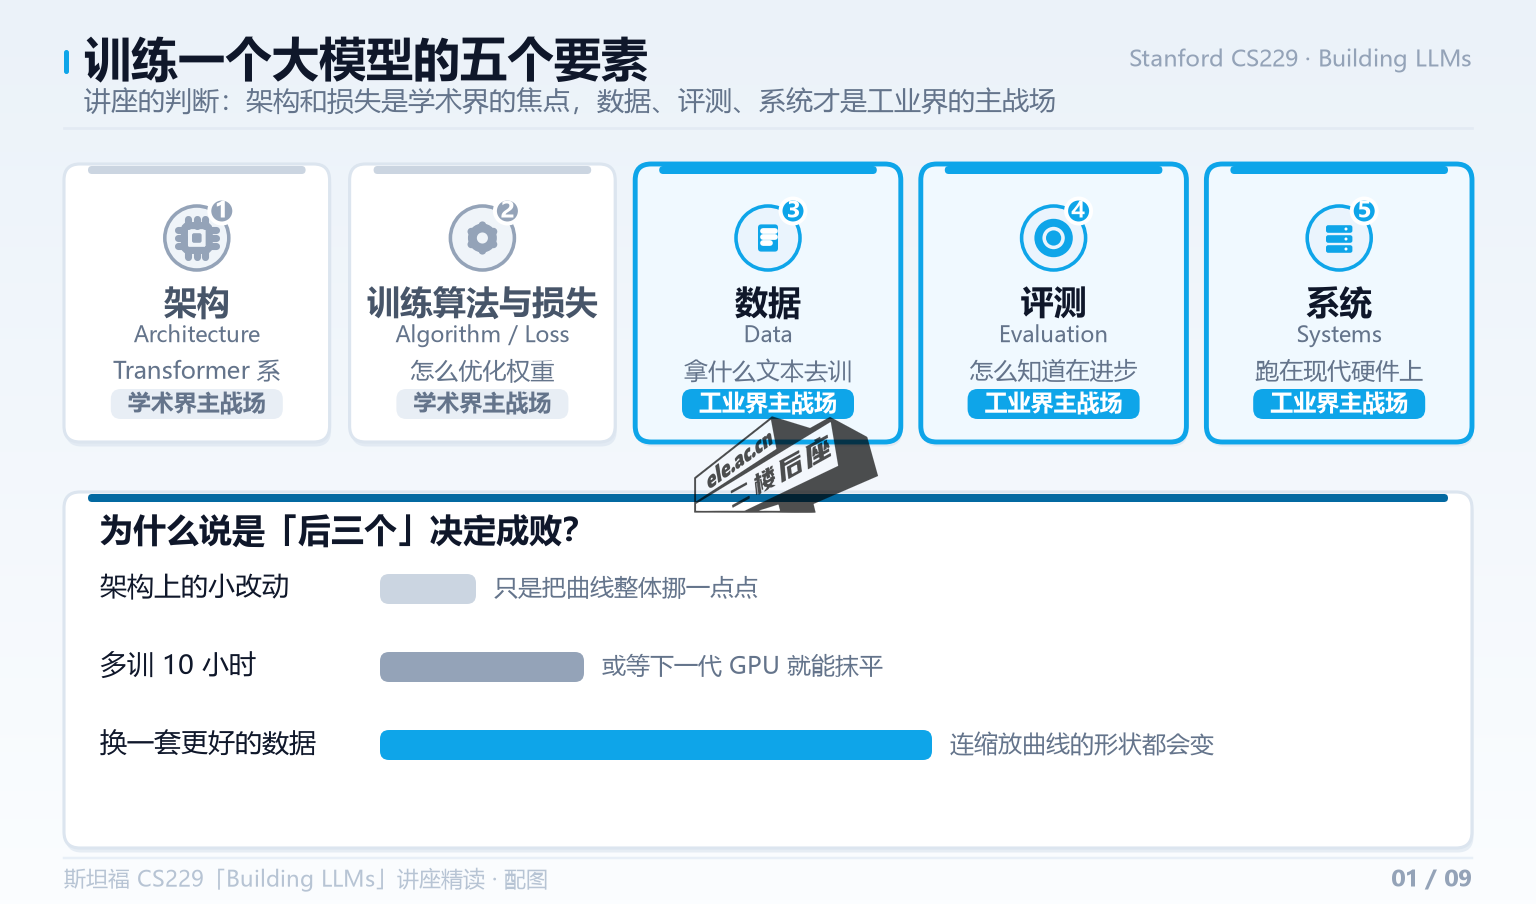
讲者把训练一个大模型拆成五个要素:
- 架构(Architecture)——用什么样的神经网络,现在基本都是 Transformer 及其变体
- 训练算法与损失(Training algorithm / loss)——怎么优化权重
- 数据(Data)——拿什么文本去训
- 评测(Evaluation)——怎么知道自己在进步
- 系统(Systems)——怎么让这么大的模型真的跑在现代硬件上
然后是他整场讲座最重要的一句话,大意是:学术界把绝大部分注意力放在架构和损失函数上,但真正在工业界决定成败的,是数据、评测和系统。他自己也说,他职业生涯里很大一部分时间就是那个盯架构的学术研究者。
为什么?因为缩放定律(后面第五节细讲)已经证明了:架构上的小改动,通常只是把曲线整体上下挪一点点,多训十个小时、或者等下一代 GPU,就把这点差距抹平了。而数据不同,用好数据和用烂数据,连缩放曲线的形状都不一样。
二、预训练:把「猜下一个词」做到极致
1. 语言模型本质上是一个概率分布
语言模型要做的事很简单:给定前文,算出下一个词的概率。一句 The mouse ate the cheese 应该得到较高的概率;加了语法错误的版本概率低一些;而 The cheese ate the mouse 因为语义上不合理,概率更低。这里面既有语法知识,也有世界知识。
因为能从这个分布里采样出新句子,所以语言模型也是生成模型。
2. 自回归与交叉熵
现在所有主流模型都是自回归的:把整句话的联合概率,用链式法则拆成一串「给定前面所有词,下一个词是什么」的条件概率。这里没有近似,就是概率乘法公式的改写。
它的代价藏在推理端:生成是 a for loop,一个词一个词往外吐,上下文越长、要生成的东西越长,耗时就越长。
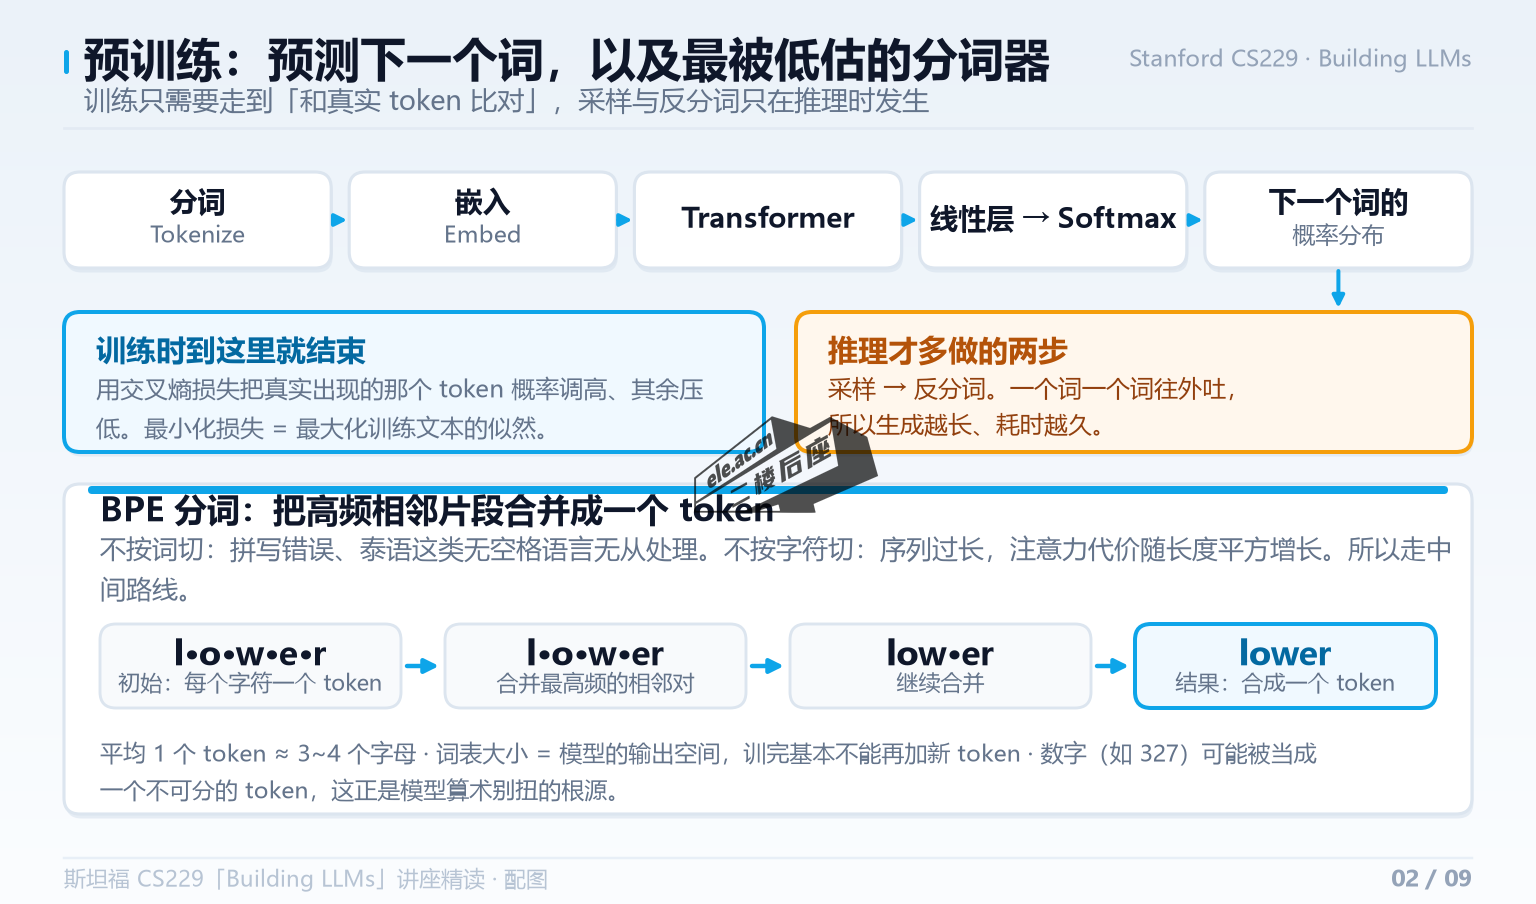
训练流程则是:分词 → 查 ID → 嵌入成向量 → 过 Transformer → 过一个线性层把维度映射到词表大小 → softmax 得到下一个词的概率分布 → 用交叉熵损失和真实的下一个词比对,抬高正确词的概率、压低其他词。
讲者特别提醒了一个容易被忽略的细节:采样和反分词这两步只在推理时需要。训练时只要预测出最可能的 token,跟真实 token 一比,然后改权重就行了。换句话说,训练是最小化交叉熵,等价于最大化训练文本的似然。
3. 分词器:最被低估的部件
讲者的原话是「大家通常不太聊分词器,但它极其重要」。为什么不能按词切?
- 有拼写错误就没词表了。一个带错别字的词可能根本不在词表里,模型不知道怎么处理它。
- 不是所有语言都用空格分词。比如泰语,词与词之间没有空格,按词切根本不成立。
那按字符切行不行?理论上可行,效果也不会差,但序列会变得极长,而注意力计算量随序列长度平方增长,代价承受不起。
所以现代分词器走中间路线:把高频子串合成一个 token,平均一个 token 大约对应3~4 个字母。最常用的算法之一是字节对编码(BPE):先在一个大语料上把每个字符都当成独立 token,然后反复找出最高频的相邻 token 对,合并成一个新 token,如此循环。
几个关键点:
- 词表大小 = 模型的输出维度。这不是一个随便能改的超参数,训完之后基本没法加新 token。
- 解码时总是选能匹配的最长 token,能切 token 就不会拆成 T + oken。
- 像 bank(银行 / 河岸)这种一词多义,分词器不管,靠 Transformer 从上下文里学。
- 数字和代码是重灾区。327 可能被当成一个不可分割的 token,模型看到数字的方式和人类不一样——人类能按位分解、逐位相加,模型做不到,所以算术特别别扭。代码也一样,Python 开头那四个空格过去被切得很怪,GPT-4 专门改了代码的分词方式。
- 讲者给了一个大胆预测:如果五到十年后出现不随序列长度二次增长的架构,分词器可能会消失。
三、预训练阶段怎么评测:困惑度与榜单
困惑度(Perplexity)
它其实就是验证损失的一个「更好读」的版本:取每个 token 的平均损失,再取指数。之所以要取指数,一是人类不擅长读对数刻度,二是对数的底数会变,指数化之后数值就落在词表大小这个统一单位里;之所以要取平均,是为了让困惑度和序列长度无关。
它的取值范围是 1 到词表大小:
- 1 表示每个词都预测得完全正确,模型毫不犹豫;
- 词表大小 表示模型完全没头绪,在所有 token 里瞎猜。
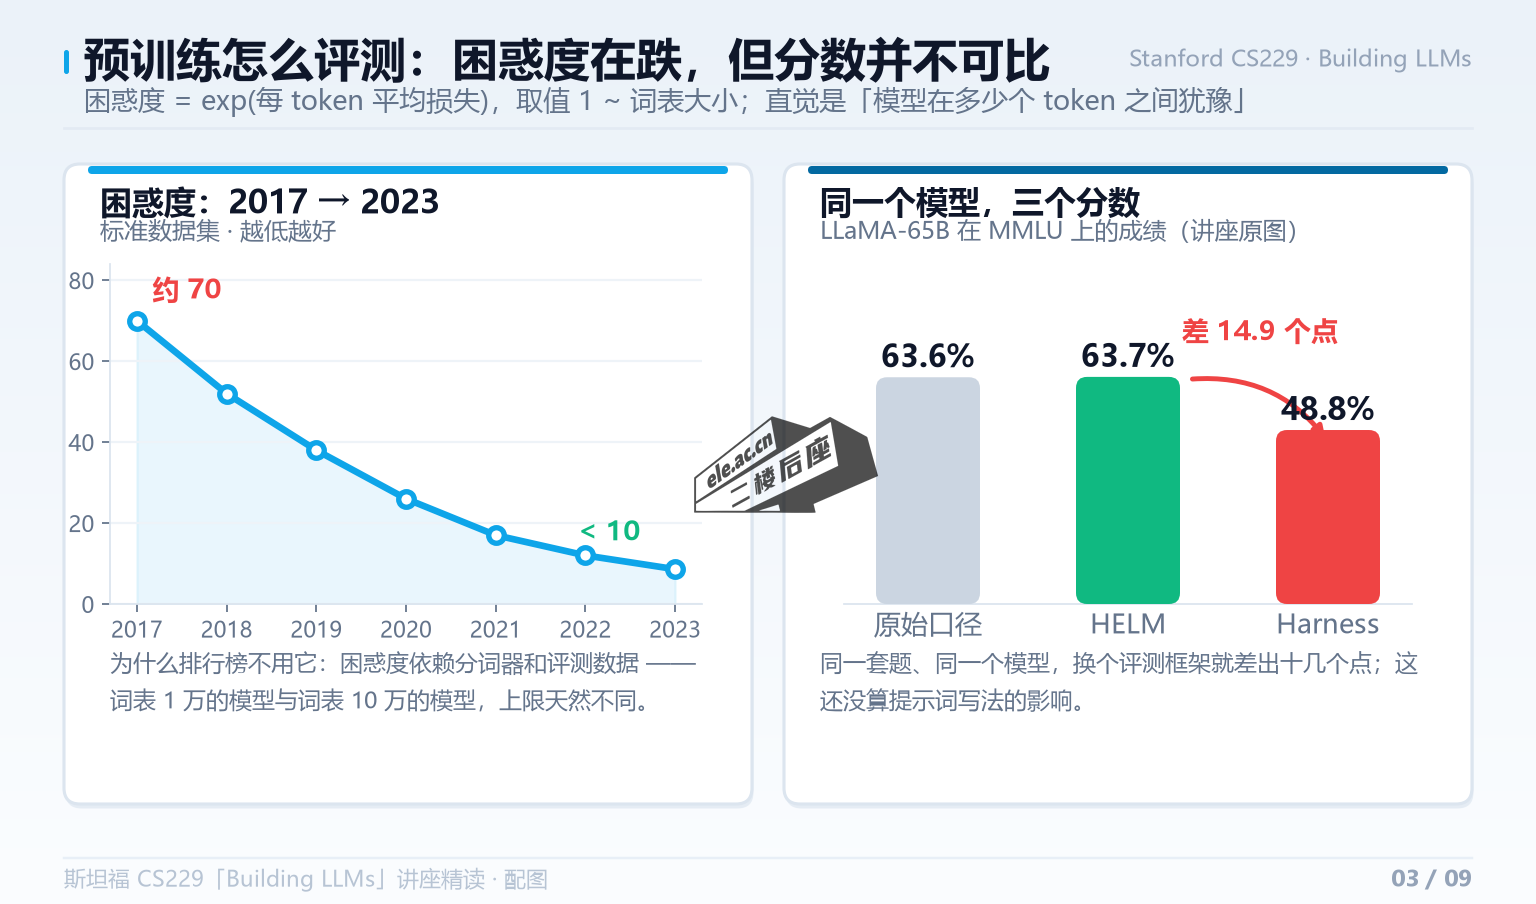
所以困惑度的直觉是——模型平均在多少个 token 之间犹豫。从 2017 到 2023 年,在一个标准数据集上,这个数字从大约 70 降到了 10 以下。
但讲者点出了它的致命伤:困惑度依赖分词器和评测数据。假设 ChatGPT 的词表是 1 万,Gemini 的词表是 10 万,那 Gemini 的困惑度上限天然就更差。所以学术榜单早就不用困惑度了——但训练自己的模型时,它依然是最重要的观测量。
学术榜单:HELM、Open LLM Leaderboard 与 MMLU
现在学术界更常见的做法,是把大量可自动评测的经典 NLP 任务聚在一起统一打分。两个最常用的:斯坦福的 HELM 和 HuggingFace 的 Open LLM Leaderboard。
最具代表性的单项是 MMLU:覆盖大学医学、大学物理、天文学等几十个学科的题库。题目形式是四选一,判分方式有两种:
- 不做生成,直接比较模型对 A / B / C / D 四个选项的似然,看哪个最高;
- 把选项写进提示里,再把模型的输出限制在 A / B / C / D 这四个 token 上。
这两种口径看似只是实现细节,结果却差得很远。
评测的两个大坑
坑一:口径不一致。同一个模型,用不同评测框架跑 MMLU,分数能差出十几个点。讲座里给了一张表,LLaMA-65B 在 HELM 口径下是 63.7,在 Harness 口径下是 48.8,在原始口径下是 63.6。而且这还没算提示词写法带来的差异。
坑二:训练集污染。模型可能在预训练时就已经见过测试题。对企业来说这不是问题(他们知道自己训了什么),但对学术界是真的麻烦。讲者提了一个很巧妙的检测方法,来自 Tatsu Hashimoto 实验室:网上大部分数据集本身没有内在顺序,那么你可以比较模型生成「按原始顺序排列的全部样本」和「打乱顺序排列的全部样本」的似然——如果按顺序生成明显更可能,那这套数据大概率在训练集里出现过。
四、数据:工程量最大的那部分
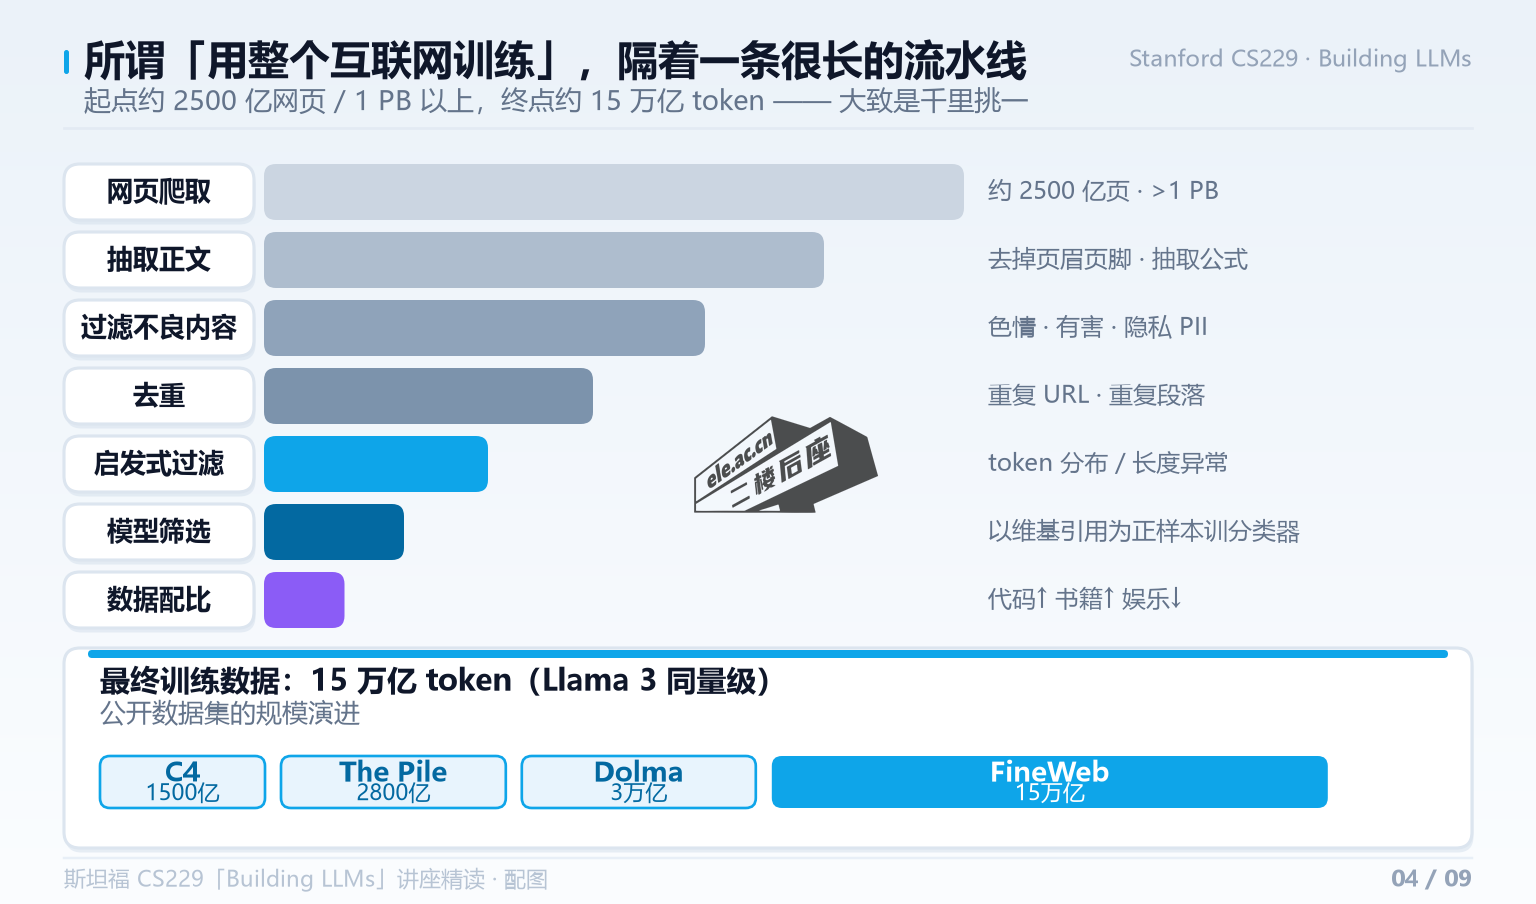
人们总说「大模型是用整个互联网训出来的」。这句话的实情是:
- 约 2500 亿个网页
- 超过 1 PB 的数据
- 其中最常用的公开爬取来源是 Common Crawl,它每月把 Google 能发现的网页增量打包发布
但那是一个「很脏」的互联网。讲者现场翻了一个从 Common Crawl 随机抽出来的页面:一眼看去全是你平时根本不会看的垃圾内容,连一句话都写不完整。
一个真实的清洗流水线
- 下载全网(2500 亿页,1 PB+)
- 从 HTML 里抽正文——难点在于数学公式的抽取,以及论坛里千篇一律的页眉页脚(boilerplate),重复内容不该进训练集
- 过滤不良内容——色情、有害内容、个人隐私信息(PII)。企业通常维护一份很长的网站黑名单,或者训一个小模型来识别 PII
- 去重——同一个网页可能有成千上万个不同 URL;同一段书里的段落可能在网上一字不差地出现了几千次。而且这一切都要在上亿文档的规模上做
- 启发式过滤——按规则剔除低质量文档:token 分布异常、词长得离谱、整页只有三个词、或者整页有一千万个词,都可疑
- 模型过滤——一个很巧的办法:把维基百科上被引用的链接都抓出来当正样本(能被维基引用的大概率是好网站),训一个分类器去判断「这篇文章像不像维基引用来源」,然后按这个分数筛选。因为要跑 2500 亿页,用的模型通常非常小
- 数据配比(data mix)——把语料分成代码 / 书籍 / 娱乐等类别,然后上下调权重。经验做法是调高代码比例有助于通用推理能力,书籍也常被调高,娱乐类通常被压低
还有一步容易被忽略:训练末期会用极高质量的数据再训一段(同时把学习率降下来),相当于让模型在维基百科和人工精标数据上「过拟合」一下。
规模参考:从 C4 到 15 万亿 token
- 公开数据集起步时大约 1500 亿 token(约 800 GB),例如 C4;The Pile 约 2800 亿 token
- 现在公开数据集已经到 Dolma 3 万亿、FineWeb 15 万亿 token
- 闭源参考:Llama 2 是 2 万亿 token,Llama 3 是 15 万亿 token;GPT-4 没有公开,传闻也是同一量级(约 13 万亿)
换句话说,最后能进模型的 token 数,大约是原始 Common Crawl 体量的百分之一到千分之一。
为什么这块最保密
讲者直接说了两个原因:一是竞争,数据配方就是预训练模型的核心竞争力,没人愿意公开;二是版权责任,他们确实在书上面训过,但一旦承认就可能被起诉。另外,很多「数据」问题到现在也没有定论——怎么更高效地处理、怎么平衡领域、合成数据行不行、多模态数据能不能反过来提升纯文本能力,全都还是活跃的研究方向。
至于人力:Llama 团队大约 70 人,其中约 15 人做数据;数据环节消耗的算力以 CPU 为主,而不是 GPU。
五、缩放定律:一张能预测未来的曲线
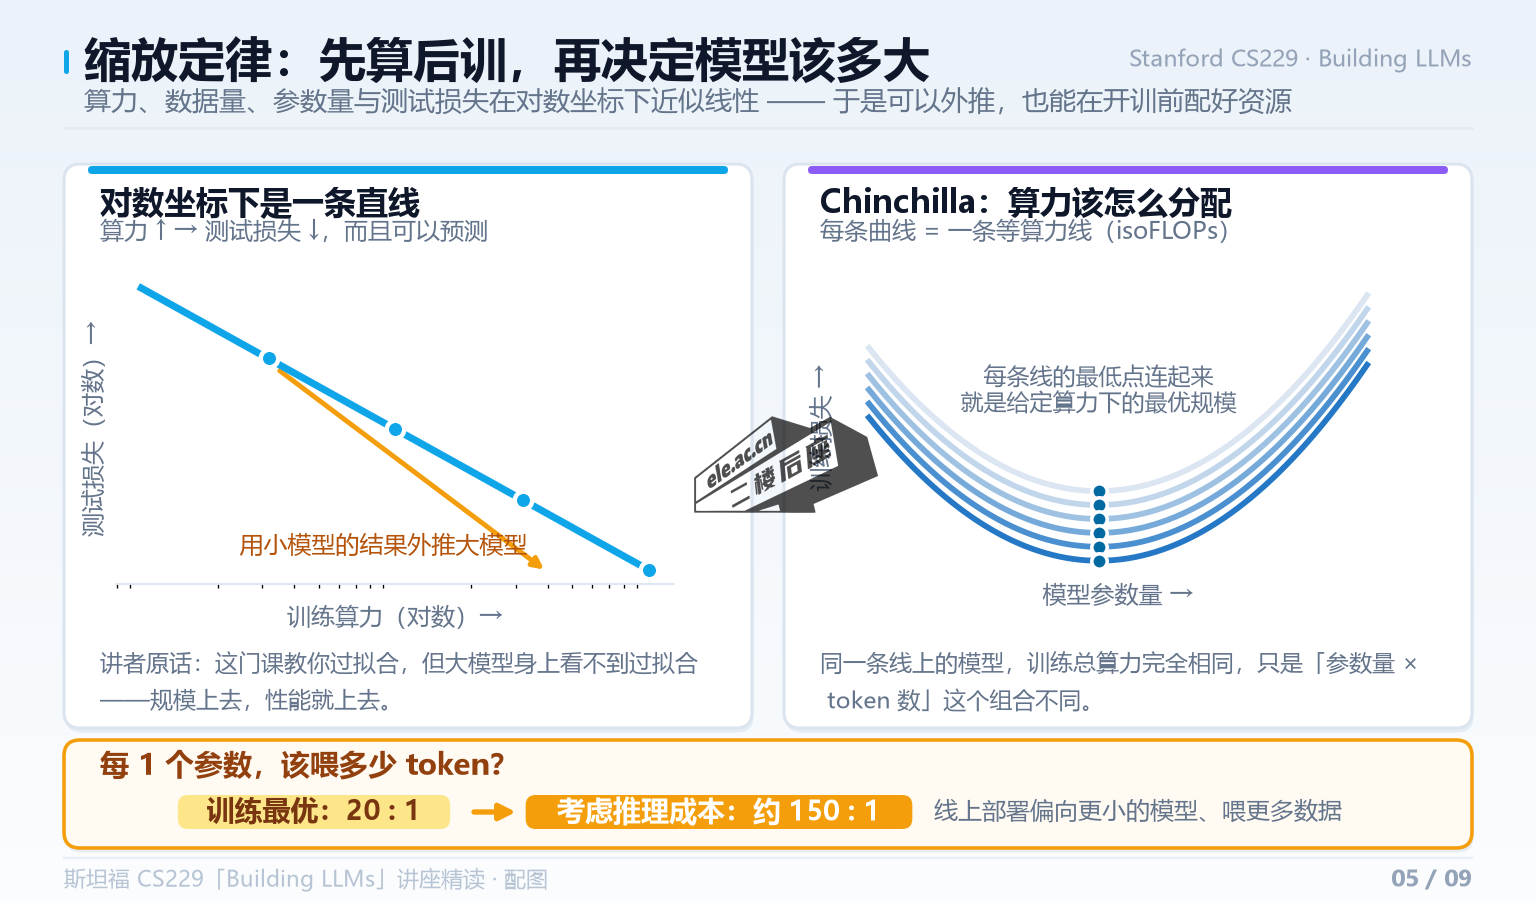
2020 年前后,业界发现:数据越多、模型越大,效果就越好,而且这件事是可以预测的。把算力(或数据量、参数量)和测试损失都放在对数坐标上,两者呈近似线性关系。
讲者强调了一点很反直觉的事:这门课教的是过拟合,但大模型身上看不到过拟合。规模上去,性能就上去。
更惊人的是这条曲线的实用性——它意味着你可以预测两三年后模型能做到什么程度。讲者说,截至讲座时这条规律仍然成立,也没有任何即将触顶的实证证据(当然,对数坐标下的下降,本来也不意味着数学上必然存在平台期)。
它直接改变了训练方式
| 旧做法 | 新做法 |
|---|---|
| 30 天里训 30 个「只训 1 天」的模型,挑最好的那个上线 | 先定缩放配方(例如模型变大时学习率该怎么调) |
| 结果是最终模型实际只训了 1 天 | 用几天在小模型上做超参调优 |
| 拟合缩放曲线,外推到大规模 | |
| 把剩下的 27 天全部花在那一个大模型上 |
讲座里举的例子是 Transformer 对比 LSTM:你先分别训一堆不同规模的 Transformer 和 LSTM,拟合各自的曲线,然后外推——从图上就能看出 Transformer 明显更好。看曲线要看两件事:斜率(scaling rate)和截距。有可能某个方案起步更差,但在某个规模之后反超。
也正因为如此,学术界那些「换个新激活函数、新小结构」的改进,往往只是轻微移动截距——多训十小时,或者等下一代 GPU,就把这点差距吃掉了。这就是第一节那个结论的来源。但数据不一样:用高质量数据,整条缩放曲线的形状都会更好。
Chinchilla:到底该把算力花在「更大的模型」还是「更多的数据」上
这是缩放定律最有用的推论。Chinchilla 那篇论文的方法是:画出若干条等算力线(isoFLOPs)——同一条线上的模型,训练总算力完全相同,只是「参数量」和「token 数」的组合不同;然后把每条线上表现最好的那个点拎出来,再拟合一次曲线,就能得到「给定算力预算,最优参数量是多少、最优 token 数是多少」。
结论是:参数每增加 1 个,就应该多喂约 20 个 token——这是「训练最优」的配比。
但现实中还有推理成本。模型越小,上线后每次调用越便宜,所以如果把推理成本算进来,最优配比会推到每参数约 150 个 token——也就是故意用更小的模型、喂更多的数据。这大概就是目前实际部署的模型所采用的策略。
六、一次训练的账单:讲者的现场估算
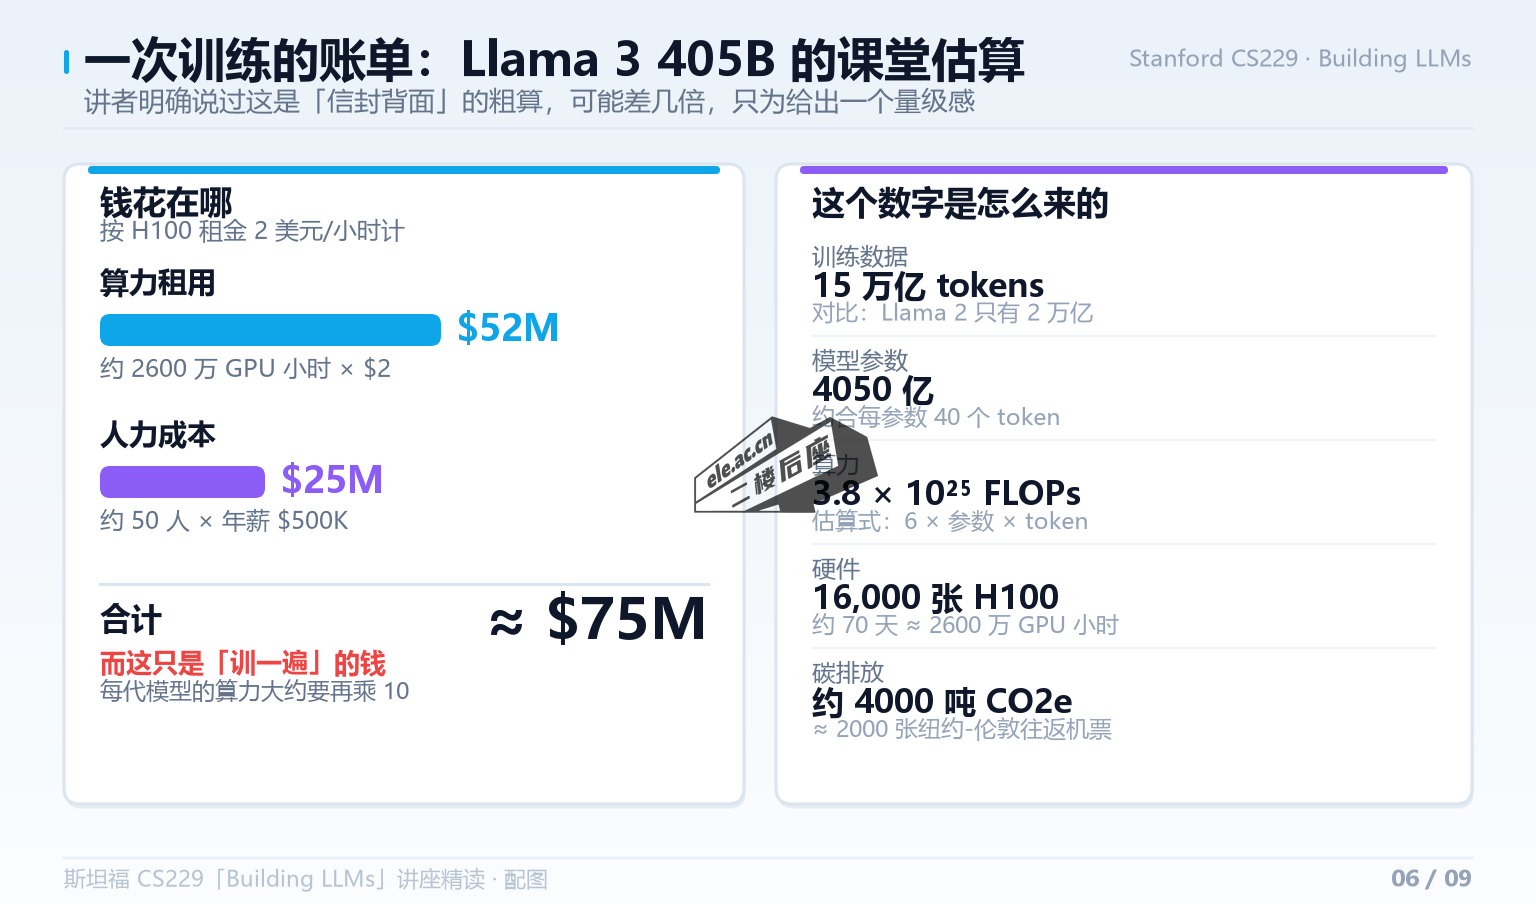
讲者拿 Llama 3 405B 做了一次「信封背面」的估算,并明确说可能几倍地不准,只是给大家一个量级感:
- 训练数据 15 万亿 token,参数 4050 亿,约合每参数 40 个 token——介于 Chinchilla 的训练最优(20)和推理最优(150)之间
- 算力用一条简化公式估算:FLOPs ≈ 6 × 参数量 × token 数,得到约 3.8 × 1025 FLOPs。讲者顺带提到,这个数字刻意压在某个算力审查门槛(1026)之下
- 已知用了 16,000 张 H100,估算约 70 天、2600 万 GPU 小时(Meta 官方口径是 3000 万小时)
- H100 租金下限按 2 美元/小时算,硬件成本约 5200 万美元;团队按 50 人、年薪 50 万美元算,人力约 2500 万美元
- 合计约 7500 万美元
- 碳排放约 4000 吨 CO₂ 当量——讲者换算成「2000 张纽约往返伦敦的机票」,并认为目前还不算致命,但每代模型算力大约要翻 10 倍,到 GPT-6、GPT-7 那一代可能就成真问题了
这组数字的价值不在于精确,而在于让你明白:「多训一遍」的成本是以千万美元计的,所以为什么大公司宁可先把钱花在小规模实验和缩放曲线上,也不愿意直接把大模型跑起来试错。
七、后训练:从「文字接龙机」到「AI 助理」
预训练出来的模型不会好好回答问题。讲者举的例子非常直观:你问 GPT-3(纯语言模型、未对齐)「用六岁小孩能懂的话解释登月」,它给你的回答是——「用六岁小孩能懂的话解释引力理论」。因为在它见过的语料里,一个问题的后面通常跟着另一个问题,而不是答案。
所以需要对齐(alignment)。目标有两个:让模型听懂并遵循用户的指令,以及符合设计方的意图(比如内容审核——问它写一条宣扬仇恨的推文,它应该拒绝,而不是照写)。
背景矛盾在于:预训练数据是「不想要、但量极大」,而对齐数据是「很想要、但极少极贵」。解法就是——先在全互联网上预训练,再用少量「理想答案」去微调,改动一点点权重。
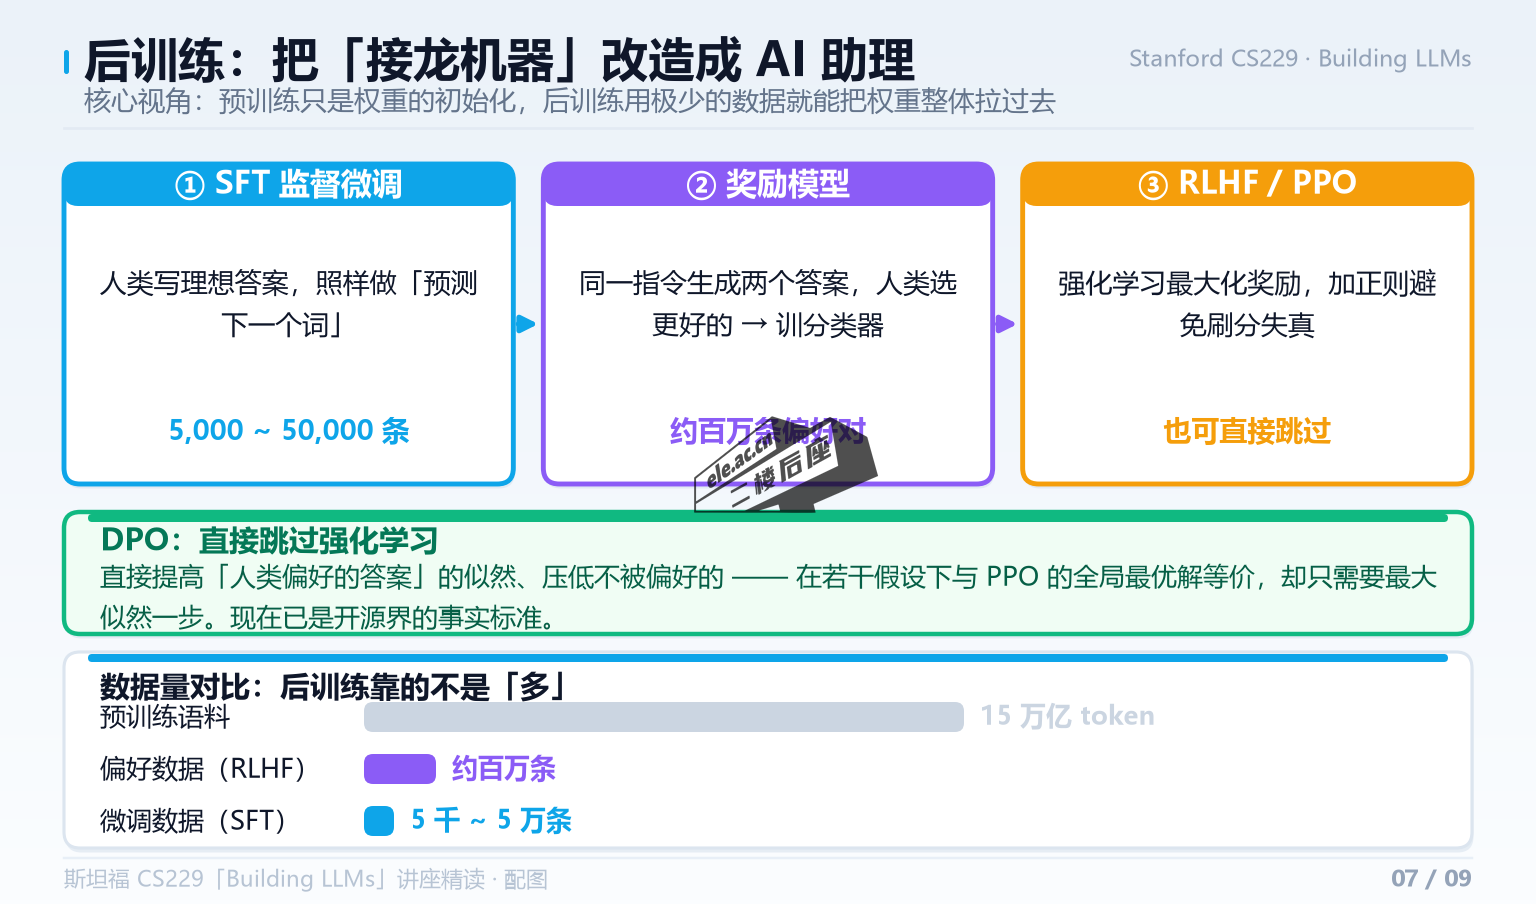
SFT:监督微调
做法就是让人类写出理想答案,然后照样做「预测下一个词」的语言建模——所以叫「监督」,因为监督信号是人工写的答案。
有意思的是,SFT 并不需要很多数据。LIMA 那篇论文显示,把微调数据从 2000 条扩到 32000 条,提升非常有限。讲者的解释是:SFT 不教模型新知识,它只是把「预训练语料里的某一类回答者」的权重调高——预训练模型本来就模拟了互联网上所有类型的用户(有人写要点、有人写整段答案),SFT 只是告诉它「你以后多向这一类用户靠」。
SFT 有三个毛病:
- 受限于人类的能力。人类能分辨哪个答案更好,但不一定能写出最好的答案。就像我能判断一本小说好不好看,但我写不出我想看的那本小说。
- 幻觉可能就来自 SFT。这是讲者觉得挺有意思的一个假说:如果人类在答案里写了一条模型预训练时没见过的参考文献,从模型的角度看,人类等于是在教它「编一个听起来合理的引用」。所以哪怕是完全正确的 SFT 数据,也可能训出「张口就编」的倾向。
- 贵。写理想答案极其耗时耗钱。
Alpaca 就是针对第三点的实验:拿 175 条人工问答做种子,让当时最好的模型扩充出 5.2 万条问答,然后微调 LLaMA-7B——这就是一个「用 LLM 生成训练数据」的早期范例,如今已经发展成一整片叫合成数据的领域。
RLHF:把「人类更喜欢哪个」变成优化目标
流程是:每个指令让模型生成两个答案 → 让标注员选哪个更好 → 训练一个奖励模型(本质是个分类器,输出连续分数,数学上是 Bradley-Terry 模型)→ 再用 PPO 这样的强化学习算法去优化主模型,同时加正则项,避免把奖励刷到失真(over-optimization)。
这里讲者点了一个非常关键的副作用:经过 PPO 的模型已经不是在做最大似然了。它不再是「对语言的概率分布建模」,而是被训练成「只生成最优的那一句」。结果是——对齐之后的模型,困惑度就失去意义了。
DPO:用最大似然干掉强化学习
PPO 在实践里非常难伺候:rollout、外层循环、各种 clipping,细节多、文档少。于是斯坦福后来提出了 DPO——思路极其直白:提高被人类偏好答案的似然,压低不被偏好答案的似然。数学上,在若干假设下 DPO 和 PPO 的全局最优解是等价的。
区别在于流程简化了一整圈:PPO 要「收人类偏好 → 最大似然训奖励模型 → 强化学习」三步;DPO 从头到尾只有最大似然一步。实测效果相当,现在已经是开源社区的事实标准,讲者认为工业界也在用。
标注数据:人类其实没你想的那么可靠
讲座里这块信息量很大:
- 人类很贵,且很慢。在 Mechanical Turk 上,1000 条偏好数据大约 300 美元。
- 人类关注的往往不是重点。面对两个都不错的答案,大多数人会选更长的那个,而不是更正确的那个。这就是为什么你总觉得「ChatGPT 回答太啰嗦」——啰嗦是对齐造成的,越做 RLHF,输出越长。
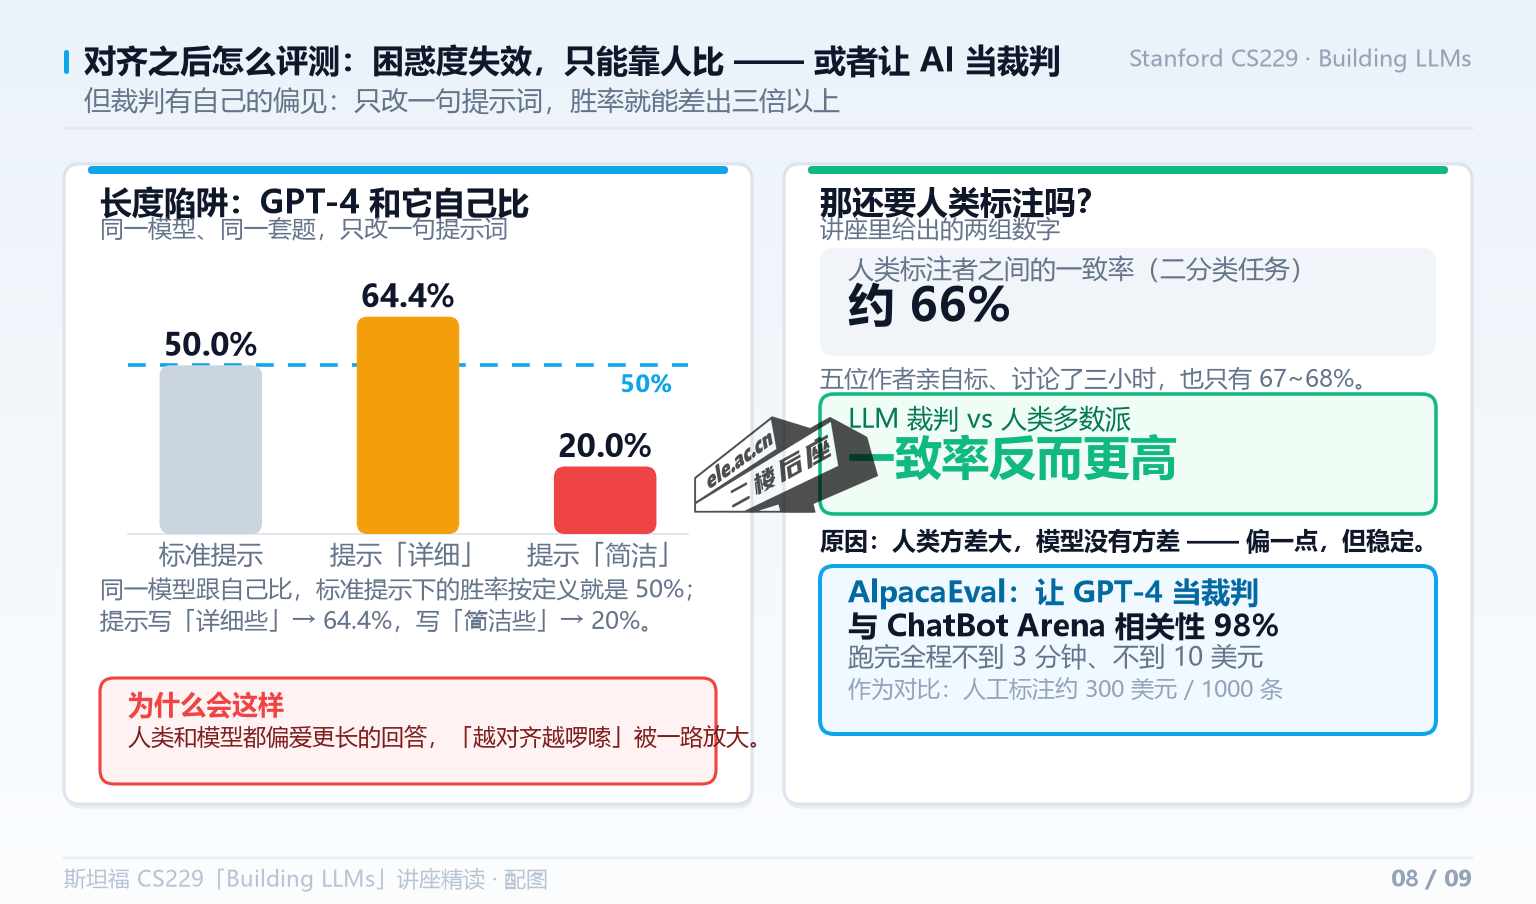
- 人类自己的一致性只有约 66%。论文的五位作者自己试着标注,认真讨论了三个小时的标准,准确率也只有 67%~68%。这不是人类不行,是这个任务本身就极难。
- 标注者分布会迁移,而且还要面对众包伦理问题——做标注的人工资不高,还得大量接触有害内容,因为要教模型避开它。
于是又是同一个套路:用 LLM 替人类做偏好标注。结果是——模型比人类便宜约 50 倍,而且和「人类多数派意见」的一致率还更高。讲者的解释是:人类方差大,模型没有方差。模型可能有偏差,但至少稳定一致。
为什么这么少的数据能改这么多
量级对比:SFT 通常 5000 到 5 万条,RLHF 大约百万条量级,而预训练是 15 万亿 token。差距是天文数字,为什么有效?
讲者给了一个很清爽的视角:把预训练看成「权重的初始化」。你没有把后训练数据和预训练数据混在一起,而是先预训练完,再只在后训练数据上微调;用的是不同的(更大的)学习率。只要学习率够大、训得够久,哪怕只有一句话,反复过几遍也能让模型只输出那一句话——所以几万条数据足以把权重整体拉过去。
顺带一个常见误解:工业界后训练通常改全部权重;开源圈常用的 LoRA 则是只给每层输出加一个增量,二者不是一回事。
八、对齐之后怎么评测:困惑度失效了,那就让人来比
后训练的评测是另一套逻辑,因为三个前提全变了:
- 不能用验证损失——一个用 PPO、一个用 DPO,损失不可比;
- 不能用困惑度——模型不再是校准过的分布,它被优化成只输出「最优那一句」;
- 题目本身是开放的——同一个问题可能有多个同样好的答案,没法自动判分。
所以最被信任的做法,反而回到了最朴素的形式:ChatBot Arena。让互联网上的随机用户在不知道模型身份的情况下,同时对两个聊天机器人提问,看完两边回答后选哪个更好;累计几十万用户之后,就能排出模型名次。局限也很明确:愿意来玩的人偏技术向,提问集中在软件报错、AI 工具这类话题;而且如果真的拿它做日常开发迭代,成本太高、太慢。
于是又轮到 LLM 上场:AlpacaEval——对每个指令,让基线模型和待评模型各生成一个答案,再让一个 LLM(比如 GPT-4)当裁判说哪个更好,最后统计胜率。两个关键数字:
- 与 ChatBot Arena 的相关性高达 98%;
- 跑完全程不到 3 分钟、不到 10 美元。
但它也有个很典型的陷阱:裁判模型偏爱更长的输出。讲座里给了一个特别有说服力的对照:让 GPT-4 和它自己比,标准情况下胜率当然是 50%;但只要在提示里加一句「请详细一点」,胜率就飙到 64.4%;说「请简洁一点」,胜率掉到 20%。同一个模型,分数能差三倍以上。
他们的解法是用因果推断做回归,把「长度」这个变量控制住——控制之后,长度带来的影响确实小了很多。
九、系统:为什么不能「多买点 GPU」
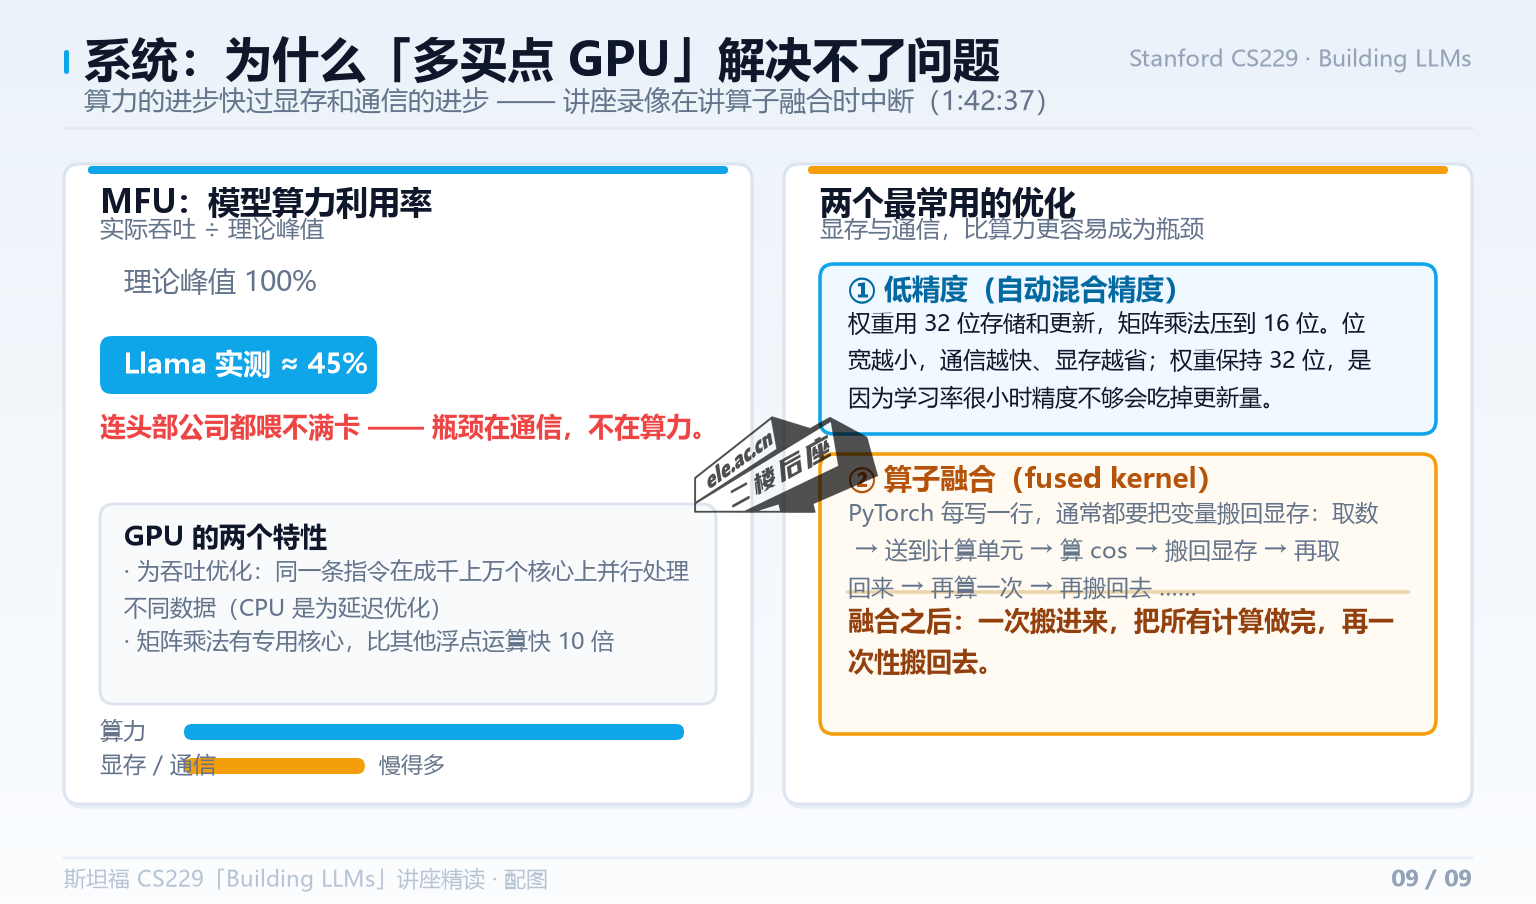
讲座最后八分钟讲系统,讲者先抛出一个问题:算力是瓶颈,那为什么不直接多买 GPU?答案是——GPU 既贵又稀缺,即使手里有 1000 万美元,也未必买得到最好的卡;而且卡一多,卡与卡之间的通信本身就要花时间。
几个关键事实:
- GPU 是为吞吐优化的,CPU 是为延迟优化的。GPU 的模型是「同一条指令在成千上万个核心上并行处理不同数据」(流式多处理器)。
- 矩阵乘法有专用核心,比其他浮点运算快 10 倍以上。这带来一个副作用:所有计算都被「逼」成矩阵乘法的形状。
- 算力的进步快过显存和通信的进步。这意味着数据喂不饱计算单元——不做优化的话,大部分 GPU 时间其实在空转。
- 衡量这件事的指标是 MFU(模型算力利用率)= 实际吞吐 / 理论峰值。一般来说能到 50% 就很满意了;Llama 大约是 45%——也就是说,连头部公司都喂不满卡。
两个最常用的优化手段
低精度:位宽越小,通信越快、显存越省。而深度学习恰好对小数精度不敏感——矩阵乘法、SGD 本身噪声就很大,权重更新 0.01 还是 0.015 根本无所谓。所以矩阵乘法用 16 位,而权重以 32 位存储、也以 32 位更新——因为学习率很小时,如果权重本身精度不够,更新量会被直接吃掉。这就是常说的自动混合精度。
算子融合(operator fusion):PyTorch 里每写一行代码,通常都要把变量搬回显存。写成 x1 = x.cos() 再 x2 = x1.cos(),实际发生的是:取数据 → 送到计算单元 → 算 cos → 搬回显存 → 再取回来 → 再算一次 → 再搬回去。极大浪费。融合的思路是:一次搬进来,把所有计算做完,再一次性搬回去。这就是 fused kernel 在做的事。
讲座的录像正好在讲算子融合时中断(视频总长 1 小时 42 分 37 秒),系统这一节是压缩着讲完的。
十、把这一课压缩成 8 条
- 架构不是重点。小改动的收益会被「多训十小时」抹平;决定成败的是数据、评测和系统。
- 分词器被严重低估。它决定了词表大小(也就是模型的输出空间),并且直接解释了为什么模型做算术这么别扭。未来如果出现线性复杂度的新架构,分词器可能会消失。
- 困惑度只在预训练阶段有意义。它是「模型在几个 token 之间犹豫」,但对齐之后完全失效。
- 分数不可信,除非你知道口径。同一个模型、同一套题,不同评测框架能差十几个点;训练集污染还要额外验证。
- 数据的工程量被严重低估。从 2500 亿网页到 15 万亿 token,中间是抽取、过滤、去重、筛选、配比的完整流水线,而且这块最保密——原因是竞争和版权。
- 缩放定律的价值在于「先算后训」。先在小模型上定配方、拟合曲线,再决定大模型该多大、该喂多少数据。训练最优是每参数 20 token,考虑推理成本则偏向 150。
- 后训练的本质是「改写作风格」,不是「教新知识」。几万条数据足够,因为它只是把预训练里已有的某一类回答者权重调高。而 DPO 已经把强化学习这一环简化成了纯最大似然。
- 对齐有副作用:啰嗦、以及可能助长幻觉。人类标注偏爱长答案,越对齐越长;而人类写出模型没见过的「正确答案」,可能反而在教它编造。
关于本文的来源与版权
本文是对 Stanford CS229: Machine Learning 课程特邀讲座 Building Large Language Models (LLMs) 的中文整理与解读,不是逐字翻译,也不是原文的替代品。讲座由 Yann Dubois 主讲(斯坦福 CS 博士生,导师为 Percy Liang 与 Tatsunori Hashimoto,Alpaca 团队成员),Stanford Online 于 2024 年 8 月发布,全长约 1 小时 44 分。讲座的版权归斯坦福大学与主讲人所有,本文观点与数据均归原作者;文中数字如无特别说明,均为讲座中给出的口径,其中训练成本、算力、碳排放等为讲者课堂上的粗略估算。
本文插图共 9 张,由本文作者依据讲座中讲者的原话与现场给出的数字绘制(图中的数字均有讲座原文出处),用于示意说明,不等同于讲座原始幻灯片;封面图为 AI 生成的示意插画。





暂无评论内容