

一、它到底在解决什么问题
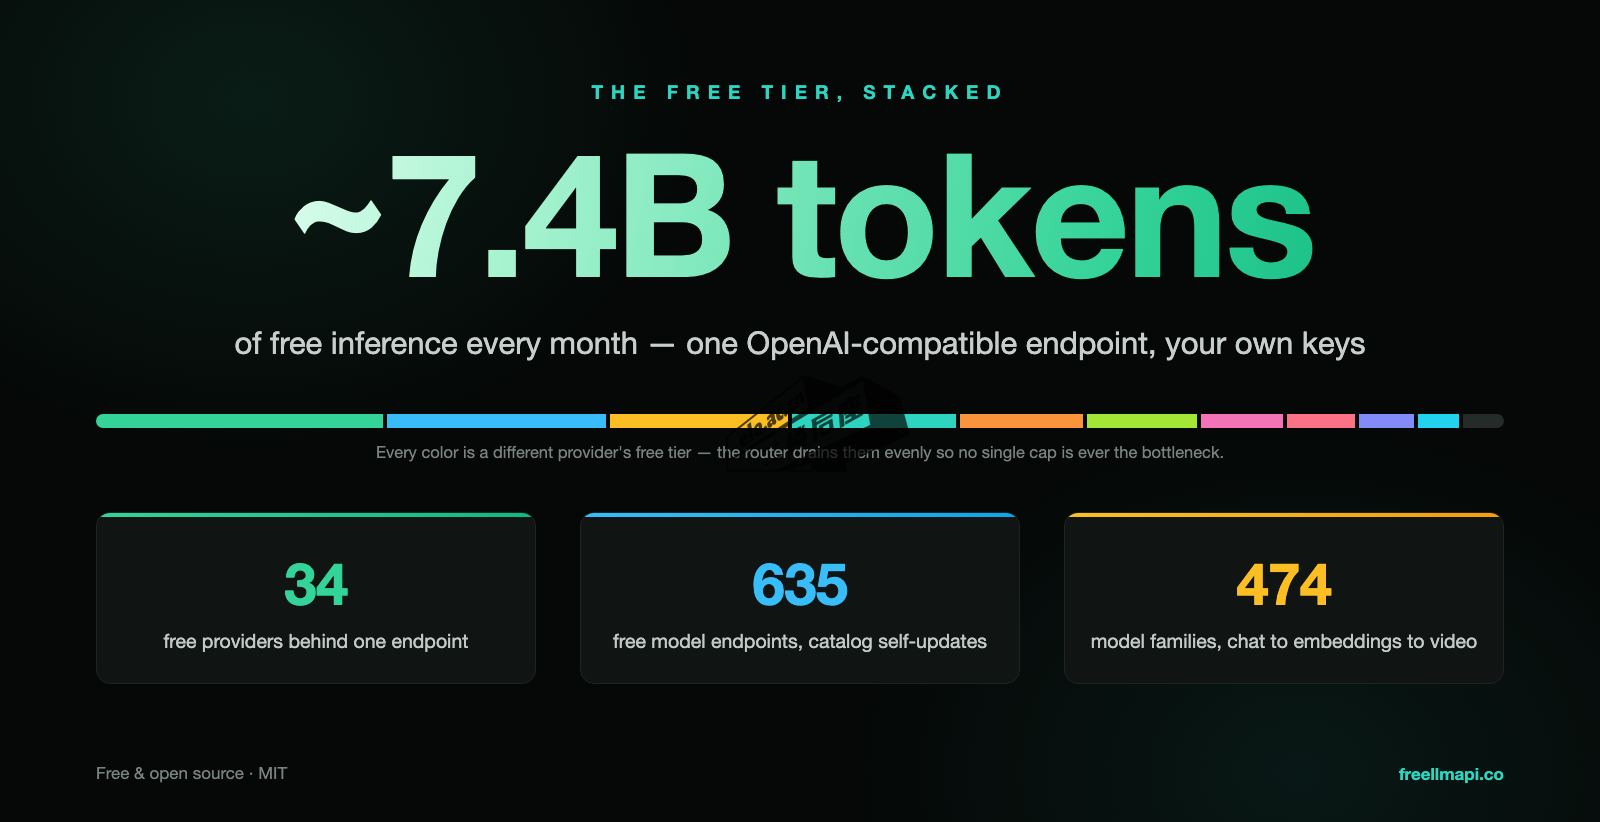
现在几乎每家 AI 实验室都在送免费额度:Google 给一点、Groq 给一点、Cerebras 给一点,每月几百万词元、每天几千次请求。单独拎出来,每一份都只够玩票;叠在一起,合计是每月约 74 亿词元的推理能力,覆盖 474 个模型系列、635 个提供方端点。
问题在于「手工叠加」这件事本身太痛苦:
- 34 套 SDK、34 套鉴权写法——每家一个 base_url、一个 key 格式;
- 34 套限流规则——有的是每分钟请求数,有的是每天词元数,还有的是「免费的只能用这个小模型」;
- 34 个可能失败的地方——某家一限流,你的脚本直接抛错,没有自动兜底;
- 额度格局每周都在变——上新、下线、悄悄调低限额,你得自己盯。
FreeLLMAPI 把这些收拢成一个 OpenAI 兼容端点:你把用过的那些提供方的密钥填进去,之后所有客户端都只指向它。它替你挑模型、替你扛限流、替你盯额度变化。装一次,之后就是「加一家、少一家」的日常操作。
它和「中转站」不是一回事:数据不出你的机器。密钥加密存在你自己的 SQLite 里,请求从你的电脑直接发往你启用的上游提供方,中间没有第三方的服务器经手你的提示词。
二、能白用哪些提供方
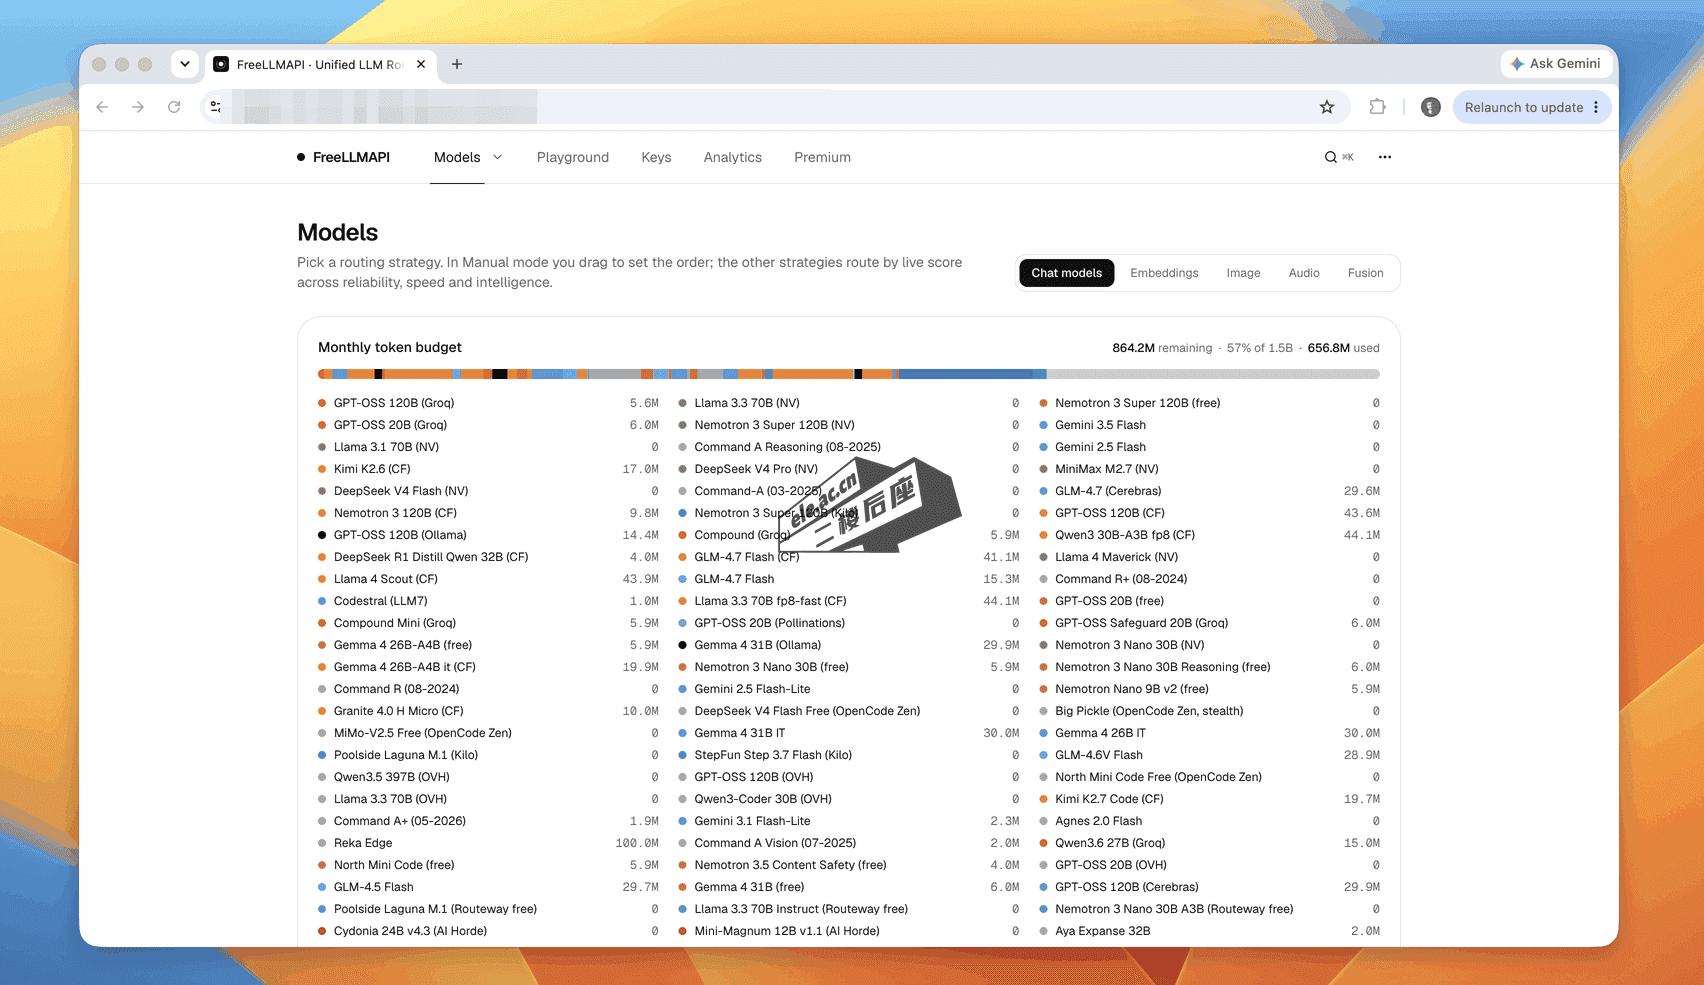
目录里目前收录 34 家,覆盖面相当广,从海外大厂到国内的智谱、魔搭都在:
| 类型 | 代表提供方 |
|---|---|
| 海外大厂 | Google、Groq、Cerebras、Mistral、Cloudflare、Cohere、NVIDIA、HuggingFace |
| 聚合平台 | OpenRouter、OpenCode Zen |
| 国内可用 | Z.ai(智谱)、ModelScope 魔搭(Qwen3 / DeepSeek V4 / GLM-5,需绑定阿里云中国站账号) |
| 其余 22 家 | 完整列表在 freellmapi.co/models,含每家的限流规则、上下文窗口与免费词元额度 |
除了这 34 家,还有一个「自定义」提供方:在密钥页里,你可以把聊天、嵌入、图像或音频模型指向任意 OpenAI 兼容端点——本地的 llama.cpp、LM Studio、vLLM、Ollama,或者你自己的一台远程网关,都能一起挂进来。
怎么理解「74 亿词元」:它是 34 家免费额度的总和,不是某一家给的。路由器会把你的请求在多家之间摊开,避免一直薅同一家、把它薅到限流。越分散,你能一直用的时间越长。
三、装它:一行命令,或者一个 exe
方式一:一行命令(需要 Docker)
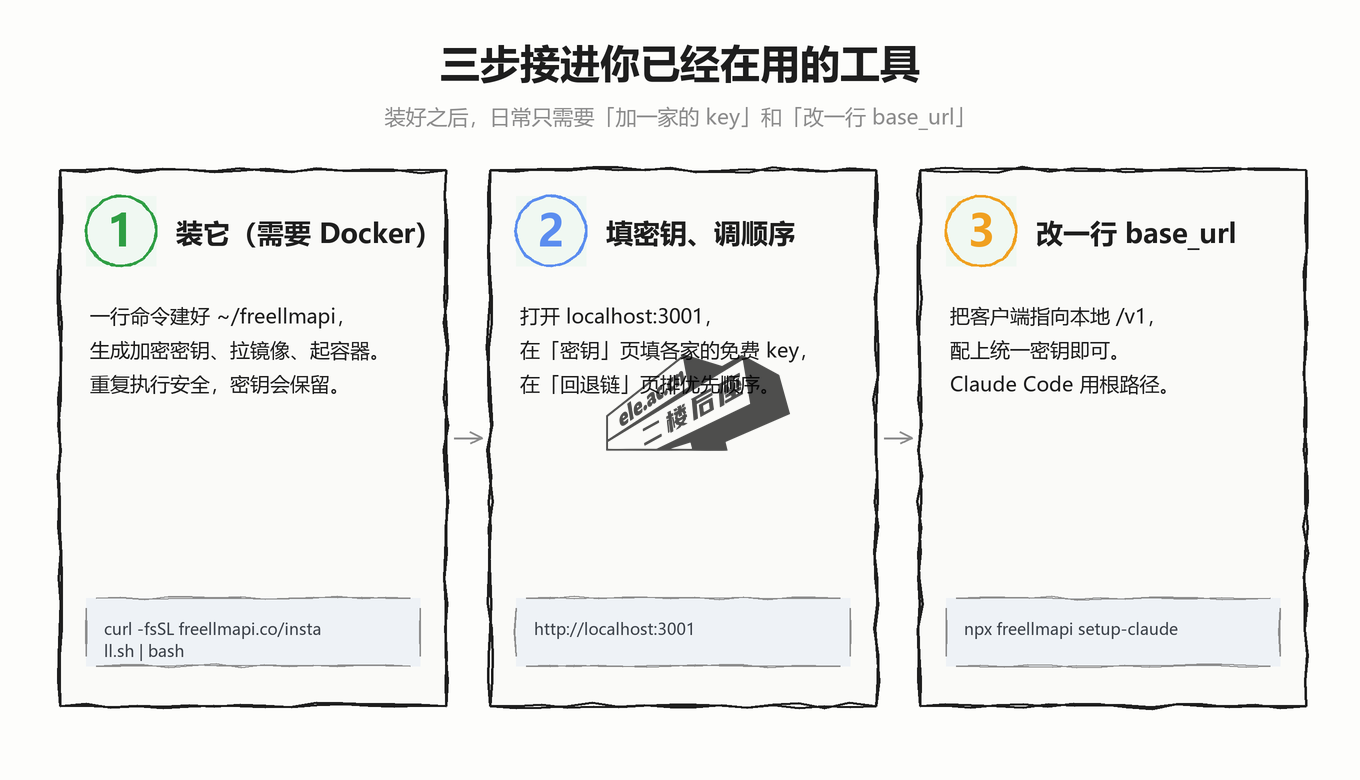
这是最省事的路径。它会建好 ~/freellmapi、生成加密密钥、拉取镜像并启动容器:
curl -fsSL https://freellmapi.co/install.sh | bash不放心把脚本直接管道给 bash,可以先看一眼 https://freellmapi.co/install.sh 的内容再执行。重复执行是安全的:你的 .env(连同加密密钥)会被保留,容器更新到最新版。
方式二:桌面版(Windows 最省事)
仓库的 Releases 里带了 macOS 的 .dmg 和 Windows 的 .exe 安装包。它是个原生的菜单栏 / 托盘应用:整个路由器加仪表盘都在本地跑,还有一个悬浮小窗实时显示请求统计。不用注册账号、不用设密码,你唯一需要的凭据就是托盘里那个统一 API 密钥。
macOS 需要 12 Monterey 或更高;Apple Silicon 选 arm64,Intel 选 x64。
方式三:Docker Compose / 源码
需要接进自己的部署流程,就照仓库 docs/zh-cn/install/01-install.md 里的 Compose 写法来;想改代码就 npm install && npm run dev——服务在 :3001、仪表盘在 :5173,两边都带热更新。
Android 上还有一份实验性的 Termux 指南,感兴趣可以自己翻。
启动之后做三件事
# 1. 打开仪表盘
http://localhost:3001

# 2. 在「密钥」页把各家的免费 key 填进去(能填几家填几家)

# 3. 在「回退链」页调顺序,然后在「密钥」页顶部
#    复制你的统一密钥 freellmapi-xxxxx
那个统一密钥,就是你接下来所有客户端要指向的东西。
四、接进你已经在用的工具
任何能指定「OpenAI 兼容 base URL」的客户端都能用:把它设成 http://localhost:3001/v1,配上统一密钥即可。
更省事的是它自带的生成器——一条命令配好,会先备份你已有的配置,而且只做合并、不覆盖:
npx freellmapi setup-claude --url http://localhost:3001 --api-key <统一密钥>| 智能体 / 客户端 | 自动配置命令 | Base URL |
|---|---|---|
| Claude Code | setup-claude |
根路径 |
| Codex CLI | setup-codex |
/v1 |
| Cline | setup-cline |
/v1 |
| Continue(含行内补全) | setup-continue |
/v1 |
| Aider | setup-aider |
/v1 |
| OpenCode | setup-opencode |
/v1 |
| Goose | setup-goose |
/v1 |
| Qwen Code | setup-qwen |
/v1(或原生 /v1beta) |
| Roo / Kilo / Crush | setup-roo / setup-kilo / setup-crush |
/v1 |
| Cursor | 参考 setup-cursor 指南 |
公网可达的 /v1 |
每个生成器都支持 --dry-run,改动前会先建带时间戳的备份。Claude Code 和 Codex 另有两个「零留存启动器」(freellmapi launch / freellmapi launch-codex),凭据只注入子进程,完全不落到配置文件里。
协议不止 OpenAI 一套。除了 /v1 全家桶,它还讲 Anthropic 的 /v1/messages(所以 Claude Code 与官方 Anthropic SDK 能直接跑在你的免费池上)、Gemini 的 /v1beta(Gemini CLI 用),以及可选的 Ollama 模拟(给 Zed、JetBrains 这类本地模型客户端用)。
五、用起来是什么样
把模型名写成 auto,剩下的交给路由器:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:3001/v1",
    api_key="freellmapi-your-unified-key",
)

resp = client.chat.completions.create(
    model="auto",   # 也可写 "auto:fast"、"auto:smart",或某个具体模型 id
    messages=[{"role": "user", "content": "用一句话概括罗马的衰亡。"}],
)
print(resp.choices[0].message.content)
print("Routed via:", resp.headers.get("x-routed-via"))
每个响应都会带一个 X-Routed-Via: <平台>/<模型> 头。你可以随时看出这一次到底是哪家在处理——这对排查「为什么今天变笨了」特别有用。
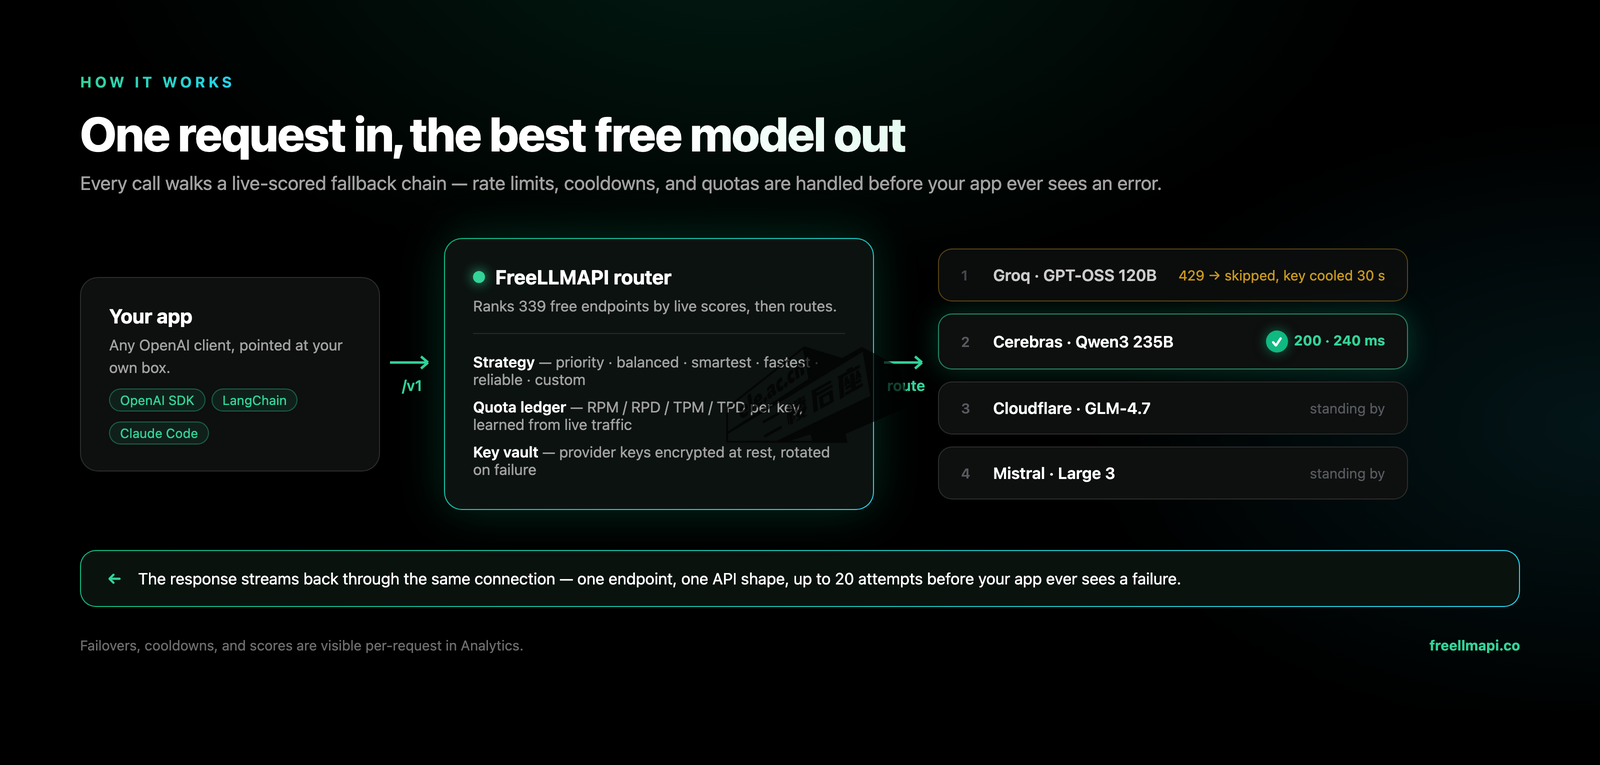
路由策略有六种可选:优先级、均衡、最稳、最快、最智能,外加按配置档指定(auto:<profile>,比如一条「写代码链」、一条「看图链」)。中途遇到 429 或 5xx,它会把这个密钥丢进冷却,然后沿链试下一个模型。
六、它凭什么稳
几个真正决定「能用 / 不能用」的工程设计:
| 机制 | 解决什么 |
|---|---|
| 按密钥的限流跟踪 | 以 (平台, 模型, 密钥) 为单位记 RPM / RPD / TPM / TPD,并学习提供方公布的额度上限,让路由永远不越线 |
| 自动降级与冷却 | 429 / 5xx 时该密钥进入冷却、自动换下一个模型;同一个模型在多家上都有的,会合并成一个条目并严格故障转移 |
| 自更新的模型目录 | 每天两次从 freellmapi.co 同步经 Ed25519 签名验签的目录:新模型、额度变更、协议修复自动生效,不用 git pull |
| 加密的密钥库 | 所有提供方密钥以 AES-256-GCM 加密存放在 SQLite,每次请求时才在内存里解密;你的应用自始至终只看到一个统一 bearer 令牌 |
| 粘性会话 | 同一段对话会在同一个模型上停留 30 分钟;万一真的换了模型,可选的「上下文交接」能让话题接得上 |
| Fusion 多模型合成 | 把 model 写成 fusion,它会并行发给几个风格不同的免费模型,再由一个评审模型把草稿合成一个答案 |
| 提示词压缩(可选) | 在缓存查找和路由之前,对提示词去重、过滤工具输出、压紧重复 JSON、裁掉过时上下文 |
| MCP 服务 | 智能体可以通过 /mcp 查询可用模型、提供方健康状况和路由策略;/v1/docs 是零依赖的 OpenAPI 浏览器 |
还有一些日常会用到的:响应缓存、加密数据库备份、定期密钥健康检查、密钥批量导入导出、声明式启动配置。仪表盘本身也做了明暗主题和 60 种语言(含简体中文,首次加载自动识别浏览器语言)。
性能上要求很低:能跑 Node 20+ 的地方都能跑,Windows、macOS、Linux 服务器,甚至一块树莓派;PM2 / systemd 常驻时空闲内存约 40 MB。
七、先说清楚它的边界
这一节建议在动手前读完——叠免费额度是有实实在在代价的:
| 情况 | 说明 |
|---|---|
| 没有前沿模型 | 免费池里是小而快的模型和上一代模型,不是各家最顶的那几个 |
| 延迟不稳定 | 多家提供方、各自的排队情况,响应时间会有明显波动,没有 SLA |
| 一天的后半段会变笨 | 顶级免费模型陆续触及当日上限,端点的实际智能水平会下滑,到 UTC 午夜(北京时间早上 8 点)重置 |
| 只是个人实验用途 | 作者写得很直接:不适用于生产环境。真要做产品,上线前请换成付费 API |
| 服务条款是你自己的责任 | 你和每家上游的关系受你注册时接受的条款约束,流量经代理转发时这些条款依然适用 |
另外,Premium 那条实时目录订阅($19/年,或 $49 买断)只是让更新更快到手上,路由器本体永远是 MIT 许可、完全免费。目录服务器看不到你的提示词、补全结果或提供方密钥——无论订不订阅,它都是完全自托管的。
最后总结一句:它把「同时用 34 家免费大模型」这件事,从「写 34 套适配代码」降到了「装一次,然后把 base_url 改一行」。0 成本、纯本地、不碰你的数据;代价是不能指望它扛生产流量——拿来跑个人项目、写脚本、做原型,正合适。
项目仓库(MIT 协议):github.com/tashfeenahmed/freellmapi · 官网与完整模型目录:freellmapi.co
站内相关
- Free Claude Code(FCC):聚合 56 个免费提供商、支持 11 种编码代理 —— 同样是「免费额度聚合」的思路,这篇更偏编码代理,可以对照着挑一个
- Grok Bot 接入微信从零开始详细教程:把 AI 助手变成微信里随叫随到的数字员工 —— 把免费模型接进常用工具的另一条路
- iPhone Use 从零开始详细教程:让 Codex 通过 USB 直接操控你的真实 iPhone —— 想让手机上的智能体也吃上这份免费池,先看这篇
- GitHub 从零开始详细教程:看懂仓库、发布作品、版本管理与开源协作 —— 第一次 clone 开源项目、跑安装脚本,先过一遍这篇





暂无评论内容