

一句话:你出一个选题,它把「讲清一件事」变成一条能直接发的视频——不露脸、不剪辑,画面上每一笔都是代码画的。
whiteboard-video 是开源合集 simon-skills 里的一条 Skill,作者 Simon 拿它跑一个真实在更新的视频号。你大概刷过这种片子:一块白板、一支铅笔,字和图跟着旁白一笔一笔长出来,两三分钟讲完一件事,全程没人出镜。
过去这种视频得一帧一帧排,现在它可以是 AI 按一行文字画出来的。下面按「它是什么 → 装它 → 用它 → 它的规矩 → 换成你的账号 → 它做不到什么」走一遍,参数以仓库当前版本为准。
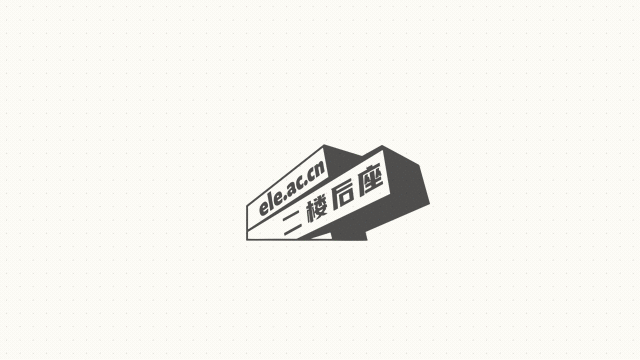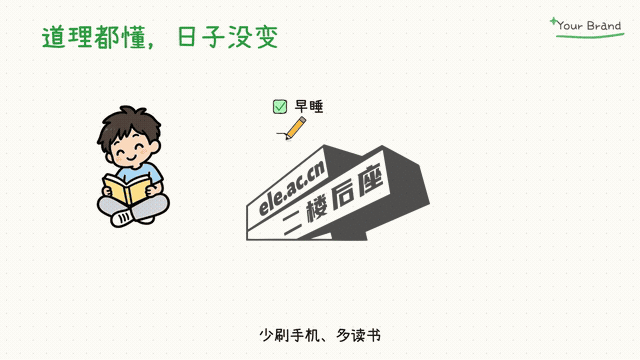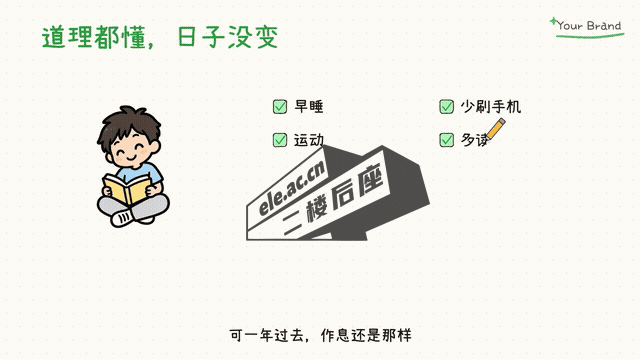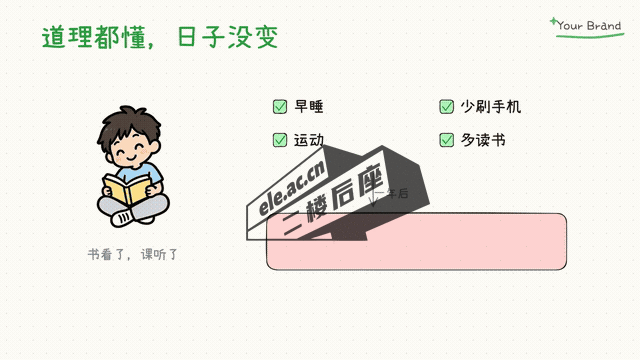
一、它不是「生成视频」,是一条能拆开的 7 步流水线
现在挂「AI 做视频」名头的产品大多是黑盒:你给提示词,它还你一段画面,中间发生了什么看不见,想改一个细节只能重新抽卡。
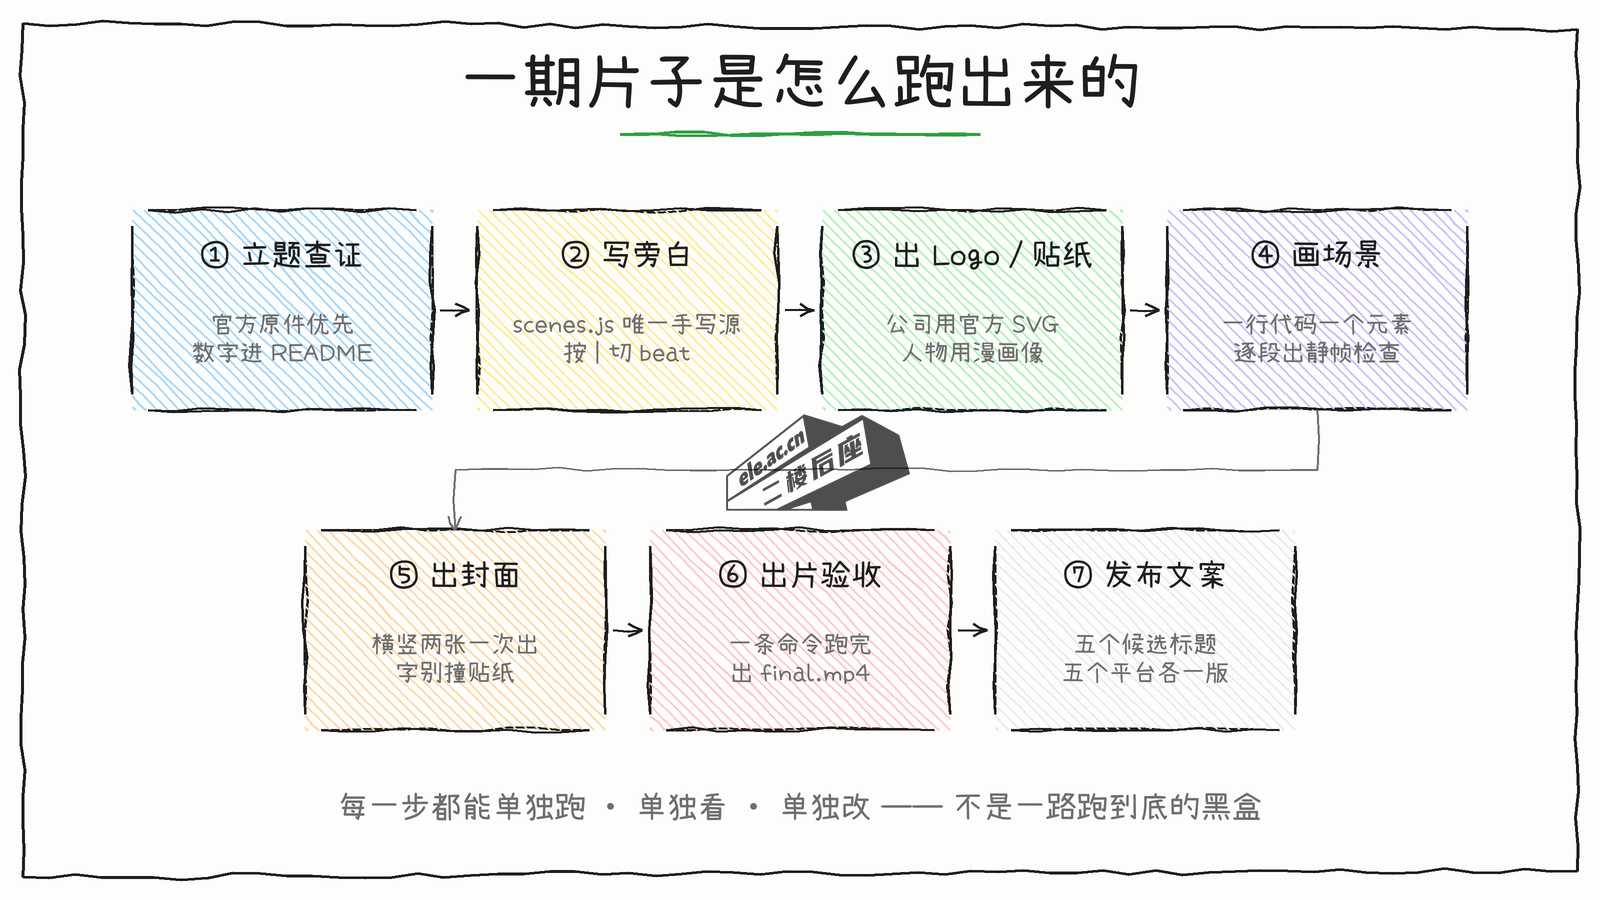
这条 Skill 正好相反——每一步都能单独跑、单独看、单独改。真正决定「画面长什么样」的只有三步,其余是纪律性的工序:
| 环节 | 用什么 |
|---|---|
| 手绘线条 | rough.js(Excalidraw 的底层库),场景同时导出 Excalidraw 格式 |
| 逐笔动画 | Playwright 在 Chromium 里逐帧截图,4 路并行 |
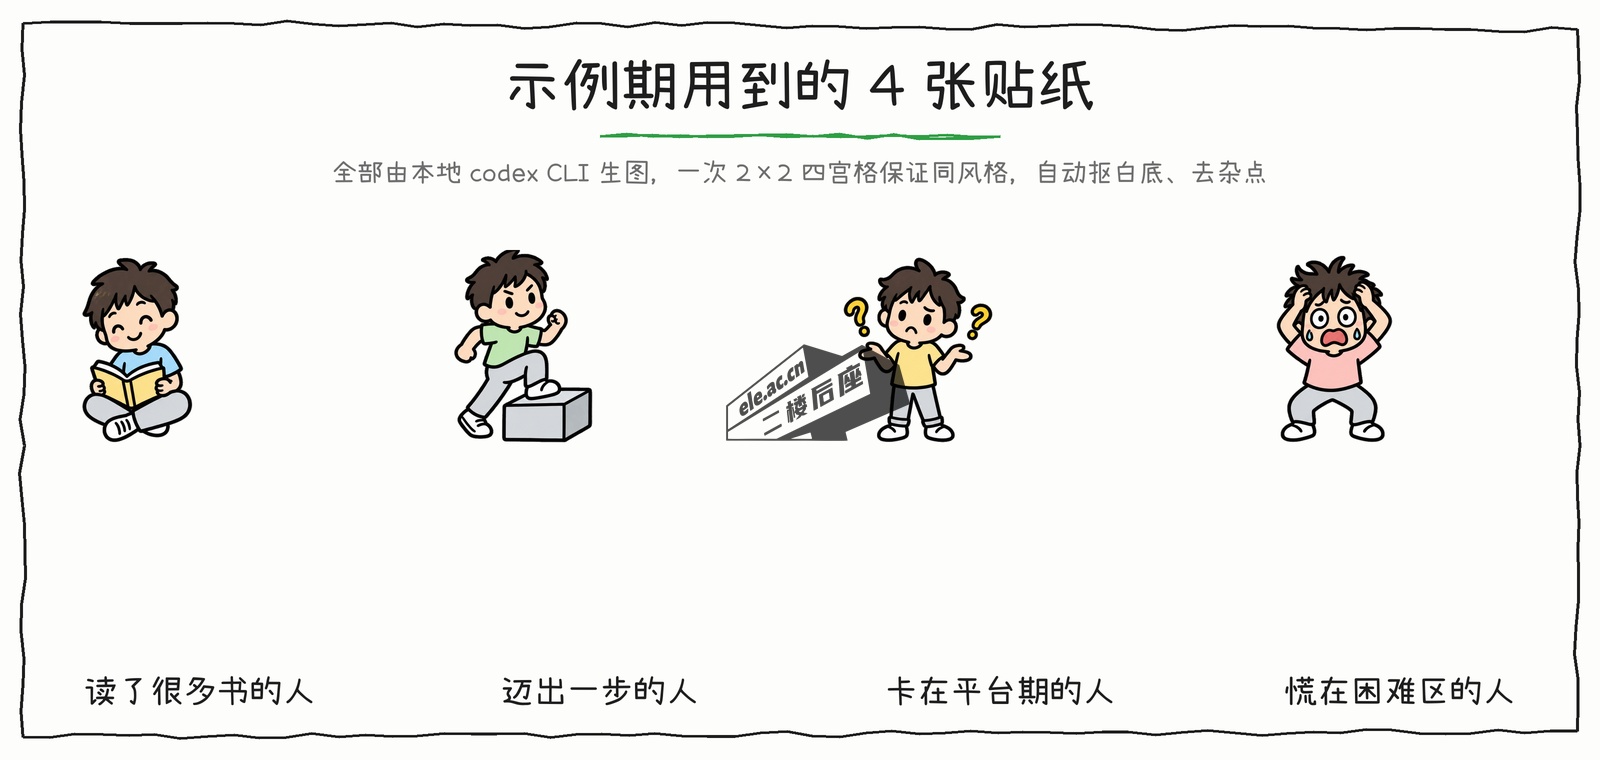
| 人物、道具 | 本地 codex CLI 生图贴纸,一次出四张同风格,自动抠白底 |
| 公司、产品标识 | Wikimedia Commons 官方 SVG,出处自动记录 |
| 配音与字幕 | 火山引擎语音合成,返回逐字时间戳,字幕照着对 |
| 合成 | ffmpeg:拼帧、烧字幕、说话时自动压低配乐 |
整条链跑完约 40 秒(配音命中缓存时),其中渲染整期只占 35 秒。
二、它交回的是「四件套」,不是一段画面
很多人只盯着成片,其实后两样对做内容的人更值钱:
| 交付物 | 是什么 |
|---|---|
| 成片 | 1920×1080 的 mp4,配好音、烧好字幕、压好配乐,直接能发 |
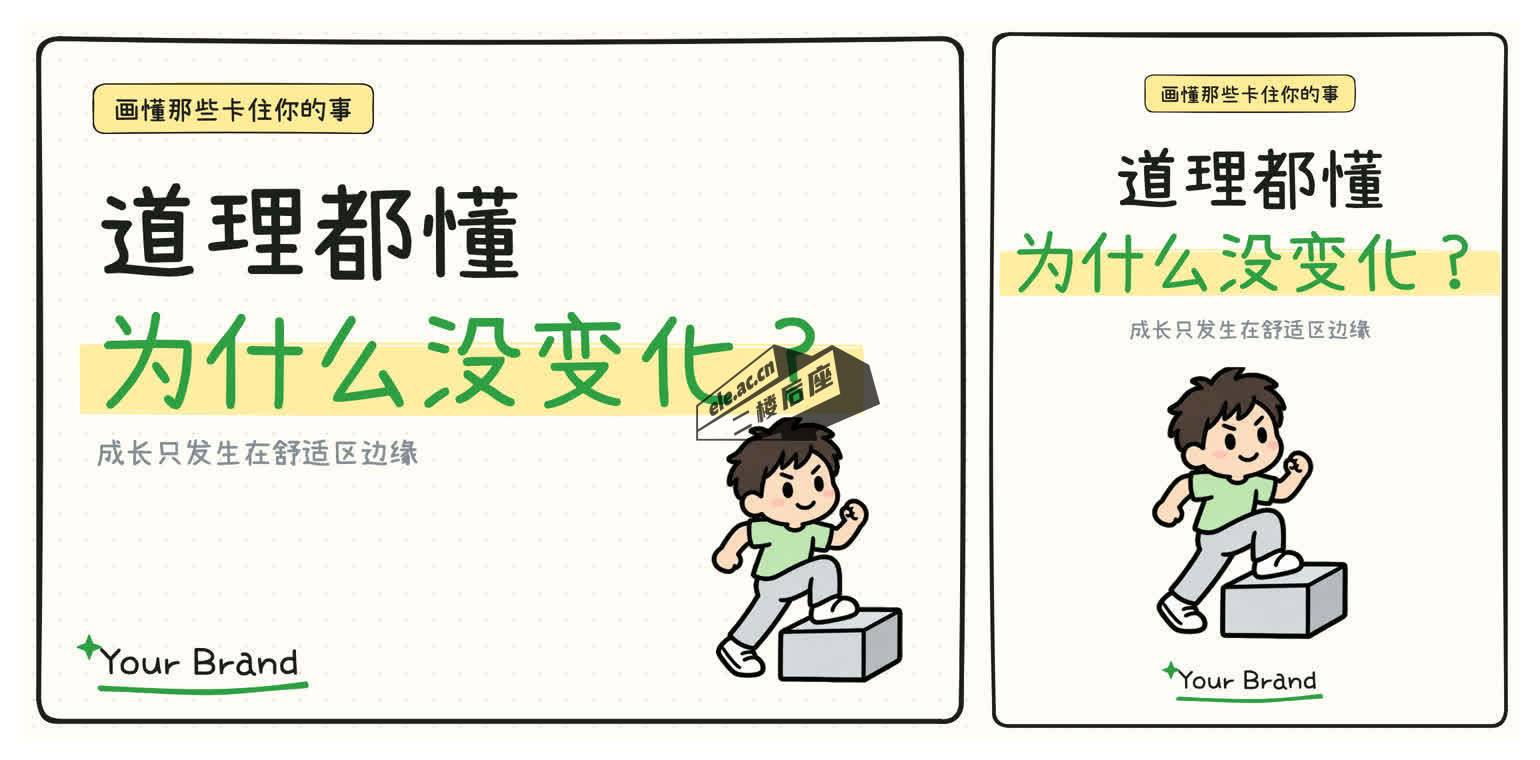
| 两张封面 | 横版 4:3 与竖版 3:4,由同一个函数一次出,不是做两遍 |
| 发布稿 | 五个候选标题(标好类型)+ 视频号、小红书、B 站、公众号、置顶评论各一版 |
| 资料来源 | 哪个数字来自哪份文件、哪句是估算,逐条列清 |
发布稿相当于把一个内容团队里「运营岗」的活固化成了模板,你拿到手只要挑个标题。
三、装它:三步命令,然后先把官方示例跑一遍
全链路本地:配音走火山引擎(凭证放在仓库的 .env),贴纸走本地 codex CLI,真实标识走 Wikimedia Commons,配乐自己放一首 mp3。不需要剪辑软件,也不把素材传到别人服务器。
| 依赖 | 说明 |
|---|---|
| Node.js 20.12+ | 用到了 process.loadEnvFile,版本低了会报错 |
| ffmpeg | 拼帧、烧字幕、混音都靠它 |
| Playwright Chromium | npm install 会自动装 |
| codex CLI | 只有出贴纸用到,登录后走你自己的额度 |
| 火山引擎账号 | 开通语音合成、凭证填进 .env;想用自己的声音就做一次声音复刻 |
# 1. 克隆
git clone https://github.com/trustfuture/simon-skills.git
cd simon-skills/skills/whiteboard-video
npm install

# 2. 填配音凭证
cp .env.example .env

# 3. 先跑官方示例,确认环境没问题(约一分钟)
mkdir -p episodes && cp -R examples/* episodes/
bin/wb build 懂很多道理
video-common 管公共工序(事实核查、合规自查、成片验收)。它必须和 whiteboard-video 一起装、并且放在平级目录,因为后者是按 ../video-common/ 引用它的。装进 Claude Code 是软链到 ~/.claude/skills/,用 Codex 就换成 ~/.codex/skills/。四、五条写死在代码里的规矩
这个 Skill 最值得抄的一点:它没写《内容规范手册》,而是把规矩变成了会报错的代码。
1. 先写旁白,再决定画什么
旁白写在 scenes.js 里,用竖线 | 切成小段(beat),每段三四句配一组元素。一期 6~8 个场景、五六百字,1.2 倍语速下成片约 2 分半。
还有一句更狠的:每个 beat 都要有能画出来的东西,抽象句并入相邻 beat。结果是这类视频里不会出现「综上所述」——因为它画不出来。内容是画面倒逼出来的。
2. 禁区是坐标,不是建议
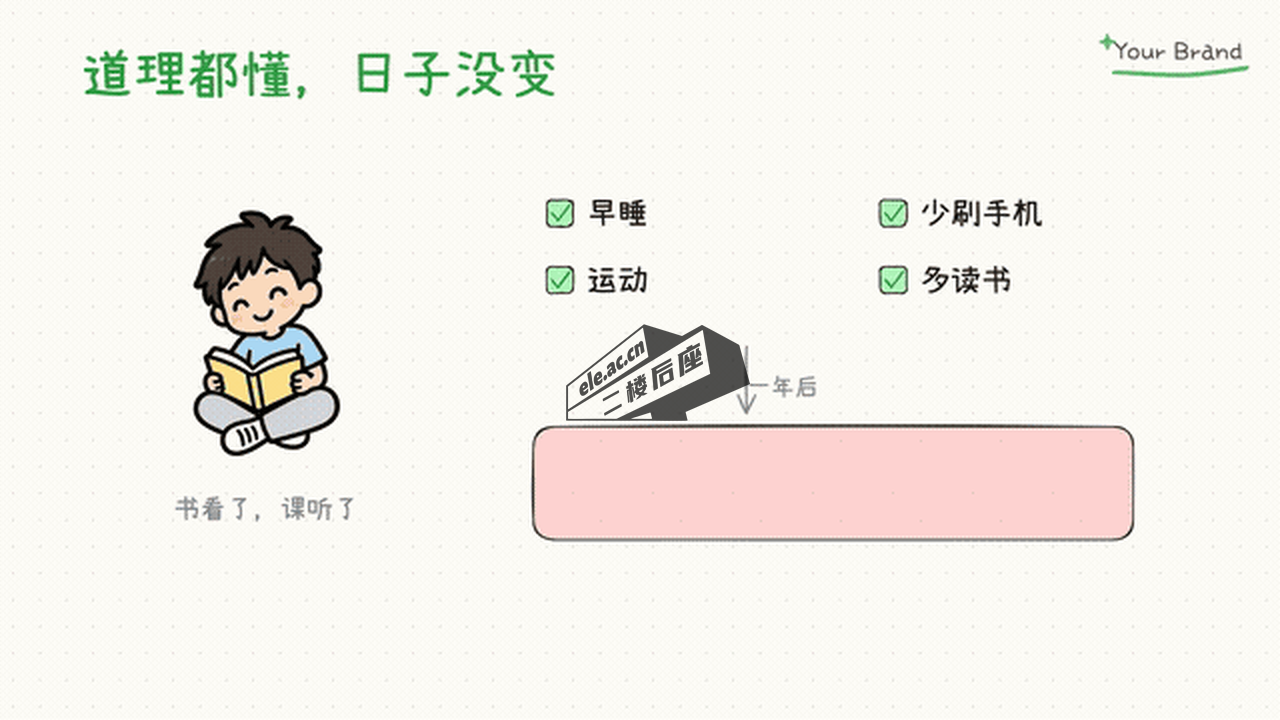
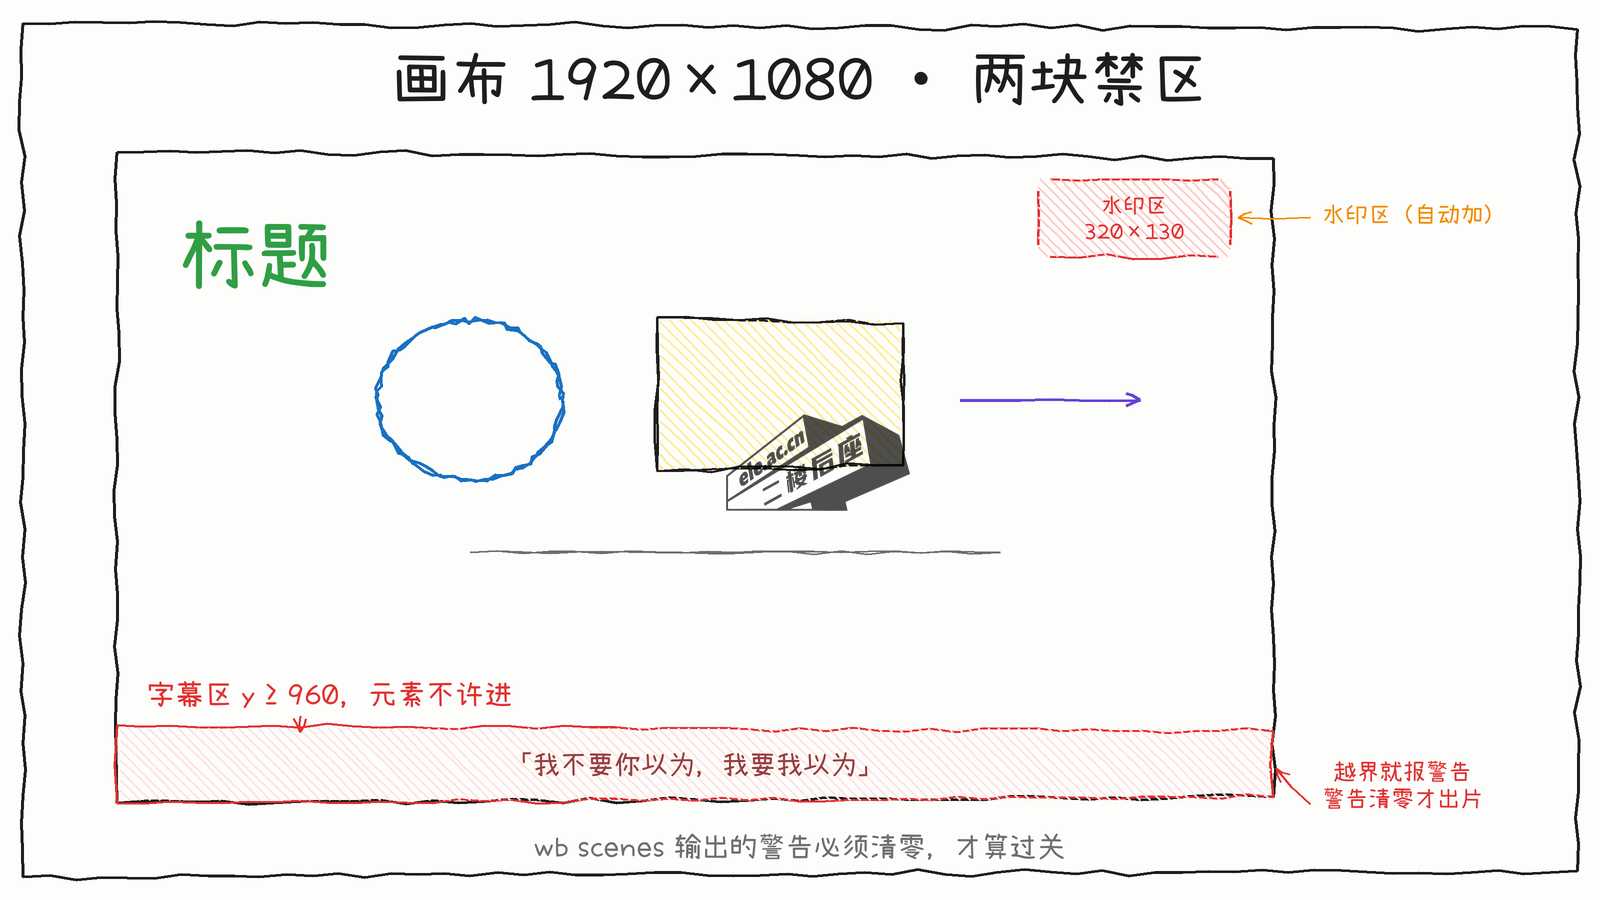
画布固定 1920×1080,两块地方元素不许进:底部 y ≥ 960 是字幕区,右上角 320×130 是水印区。压进去就报警告,而警告必须清零才算过关。
3. 一处为主,生成物不手改
scenes.js 是唯一手写源;旁白稿.md、字幕.srt、封面-*.png 全是生成物,不手改。只有 README.md(资料来源)和 发布.md(文案)是人写的。这条解决的是自动化流程最经典的死法:改了生成物,下次重跑就覆盖,然后没人知道哪份是真的。
4. 数字先查再写
数字、日期、价格必须有来源,出处写进当期 README.md;估算值都标「据报道」。而且旁白、字幕、封面、文案里的数字从同一处取。
5. 讲公司用官方标识,讲人用漫画像
理由很直白:AI 画的拟人机器人和通用小人,观众认不出是谁。所以讲到具体公司时主角用官方 SVG,讲到公众人物时用真人照片参考生成的漫画像(只借脸型、发型、眼镜和标志性服装,不丑化)。剩下那些没有真实原型的物件,才交给贴纸——因为 Excalidraw 画人很丑,这是手绘线条库的天然短板。
五、换成你自己的账号:改三行就够
右上角的手写水印、片尾品牌卡(5.5 秒、静音)、封面上的品牌标,都由工具自动生成,不用每期写。名字、品牌色、slogan 全在 config.json 的 brand 字段里:
"brand": {
  "name":   "Your Brand",          // 水印与片尾的手写名
  "slogan": "一句话说清你的账号给观众什么。",
  "accent": "#2f9e44",             // 品牌绿,水印下划线、星标都用它
  "logo":   ""                     // 有透明底 png 就填
}
- 换声音:
.env的VOLC_TTS_VOICE。官方 2.0 音色配seed-tts-2.0,声音复刻音色(S_开头)配volc.megatts.default。 - 换配乐:仓库不带音乐,放一首无版权音乐到
assets/bgm.mp3;不放就出无配乐成片。 - 接进笔记库:
dirs.projects可以指到你的笔记仓库,每期文件夹直接在笔记软件里改场景图——这一步刚好能和 Obsidian 那篇教程接上,装上 Excalidraw 插件就能像普通笔记一样拖。
六、边界:它做不到什么
做不了长视频和复杂叙事。规矩里写着「一屏 10~20 个元素」,还有一句更直白的:一个 beat 塞不下就删元素,别指望笔画得完。2 分钟是这个工具的设计上限,不是参数上限——它靠删掉画面元素来保节奏,你想做 10 分钟的纪录片,它会一路删到你把论点删没。
另外三个现实门槛:
- 要两个外部账号。出贴纸用本地 codex CLI(走你自己的额度),配音要开通火山引擎语音合成并填凭证。
- 仓库不附带音乐。自己放一首无版权音乐,或者接受无配乐成片。
- 素材版权有边界。用
wb logo取到的公司标识版权归各自所有者,只适合在评论和报道语境里原样使用,别拿去做产品宣传物料。
一句话总结:它省下的不是「剪辑时间」,而是把导演的每一个决策,固化成了配置和代码——先把不变的抽成配置,把判断标准写成会报错的规则,剩下的才交给 AI。你无法自动化的东西,往往不是因为它复杂,而是因为你从没把它写下来过。
参考来源:github.com/trustfuture/simon-skills。本文的功能、参数、授权与已知坑说明,均以该仓库当前版本为准;样片、封面与贴纸截图取自该仓库(MIT 协议)。
站内相关
- Pixelle-Video:给一个主题就自动出片,28k Star 的开源「全自动短视频引擎」——同样主打「一句话出片」,但它走全自动成片路线,两条技术路线正好对比着看。
- Obsidian 从零开始详细教程:建库、组织笔记、用 AI 打造第二大脑——把期目录接进笔记库,装 Excalidraw 插件就能直接改场景图。
- GitHub 从零开始详细教程:看懂仓库、发布作品、版本管理与开源协作——不会
git clone、看不懂仓库结构的话,先补这篇。





暂无评论内容