
X 上有一门 29 万浏览的 Grok Bot 课程(作者 Gresham,10 月 20 日发布),标题很嚣张:不升级套餐,让 Bot 的可用产出放大 10 倍。我把它整篇啃完并逐节数字核过,结论先行:它不是教你把模型变聪明,而是把你正在浪费的 87.5% token 挖出来。
同一份 100 万 token 预算,改造前每个任务平均烧 10 万 token、只有 7 份产出能直接用;改造后每个任务降到 1.25 万、70 份能用。数学是 8 倍处理量 × 1.25 倍通过率 = 10 倍可用产出。浪费来自七件事:重复读、重复查、重复做、来回带垃圾上下文、一次失败全部重来、多人多 bot 抢活、交付前不验收。升级套餐解决不了任何一条——预算翻倍只是给同一套浪费流程更大的跑道,先修流程,钱才花得值。下面按「先审计 → 七个改造 → 组装 → 算账」的顺序拆开讲,提示词模板都给你翻好了。
一、先审计:搞清 token 烧在哪
别一上来就改工作流。挑一个你重复做、而且能自己判断好坏的任务当靶子。课程全程用同一个例子:竞品监控——5 家竞品,每家产出一份带日期的简报,覆盖上次成功检查以来的价格和产品变化。简报必须链到来源、写明核实时间、和上一份存档对比、解释变化意味着什么。「确认无相关变化」也算有效产出;打不开的页面就是未完成,不许糊弄。
给这个任务建一个固定目录,让所有中间产物有地方住:
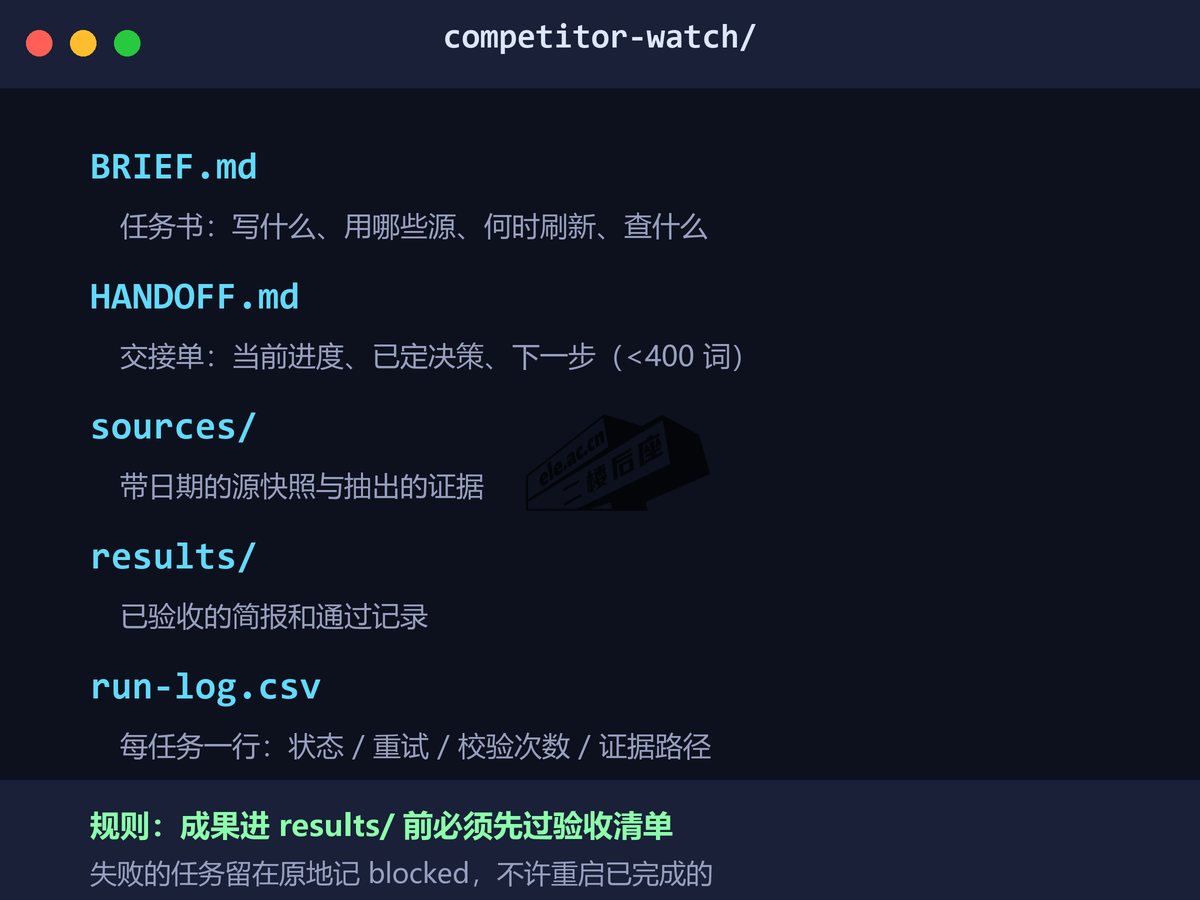
然后让 bot 自己交代重复劳动在哪,提示词模板:
这张审计表怎么读:五列里最值钱的是「观察到的浪费」和「可能的质量代价」——前者告诉你钱从哪漏,后者提醒你每条修法都不是免费的,比如砍上下文可能砍掉关键约束,压缩来源可能丢掉限定词。「事实」和「估算」必须分列,因为 bot 报出来的用量经常是猜的,拿估算当事实做决策,后面的账全歪。两个要点:先修观察到的最大浪费源(重复开网页的工作流和烂草稿满天飞的工作流,第一刀完全不同);留一次原始运行当基线,连同它的产出一起存好,不然改完连有没有变好都说不清。
二、别把昨天的对话拖进今天的任务
长对话是浪费重灾区:有用的决策、废弃的思路、原始输出、翻过案的老结论全混在一起,每一轮都陪着你重新计费。解法是把「要记住的东西」放进文件,把「对话」当成一次性的。
每个任务收尾时让 bot 写交接单:
开场白一句话就够:「读 competitor-watch 里的 BRIEF.md 和 HANDOFF.md,确认剩余任务,从存档断点继续。」关键动作是开新对话用交接单,不是在旧对话里存个文件存个安心。交接单里引用的文件必须真实存在,路径断了先修路径。
交接单长什么样?课程给了一份可直接抄的骨架:Updated(何时更新)、Goal(当前目标)、Owner(负责人)、Scope(已批准的来源清单,指向 BRIEF.md)、Complete(已完成项,各带结论和存档路径)、Unresolved(卡住的项,写清卡在哪,比如「某家更新日志两次抓取失败,价格页已核、日志覆盖情况未知」)、Next action(下一步,并写明不许重做哪些已验收项)、Boundary(边界,比如只准备建议、不许联系厂商)。常驻指令同样要克制:一个每日研究任务的开场不该带着你历来所有的写作偏好、旧项目决策和不相干的商业计划。判断交接单好不好用的标准就一条:新对话能直接接上活,不需要你重新解释一遍项目。
三、只喂任务需要的材料
价格对比需要的是价格、计费周期、席位下限和相关功能条款;它几乎不需要网站导航、Cookie 横幅、页脚和两百条用户好评。让 bot 先定问题再找材料:
课程给了三件趁手的工具,按输入类型选:本地文档翻找用 QMD(Tobi Lütke 出的本地检索小引擎,30,586 星,MIT 协议,报告、笔记、会议记录都能搜);网页正文抽取用 Trafilatura(7,011 星,Apache-2.0);API 返回几十个字段只想要三个就用 jq(35,907 星)。
以 Trafilatura 为例,在 competitor-watch 里建独立环境装好,先拿一张你人工看过定价区的页面当测试:
.venv/bin/python -m pip install trafilatura
.venv/bin/trafilatura –input-dir sources/test-html –output-dir sources/test-text –markdown –links –with-metadata
选工具的逻辑要对号入座:证据已经在你自己的历史报告和笔记里,用 QMD 翻本地;证据在网页上,用 Trafilatura 先把正文和元数据抽干净;证据是 API 吐的一坨 JSON,用 jq 把需要的字段滤出来——三个解决的是三种不同的输入问题,一次只接一个,接完先在一个输入上测通。抽取完必须抽查:对照原页面核对套餐名、价格、月付年付、币种、席位下限这些字段活没活下来,原始 URL 和抓取时间单独记在别处。有的页面价格藏在浏览器渲染里,抽完是空的——这种源就换浏览器读或换抽法,并在简报里如实标注缺了什么。测试过关后,把抽取固定成抓取后的标准步骤:下一次模型调用只喂相关段落和证据路径,原文留着备查,但别每轮对话把两个版本都贴一遍。
四、别为「没变化」买单
五分钟查一次,一天启动 288 次;一小时一次,24 次。次数差 12 倍,值不值取决于你多快会因为有新信息而行动。给竞品做周度复盘,五分钟一次的报警能改变什么决策?
按这个顺序定触发:能窄匹配的事件(源和集成支持时)优先;否则按决策截止时间倒排调度;全量分析之前,先跑一个轻量的「变没变」检查。提示词模板:
两点容易踩的坑:一是「装了插件」不等于「有了触发器」,事件驱动的启动通常要单独配置,连完插件要真测一次事件能不能叫醒 bot;二是调度给的是最低频次方案,周度复盘可以配一个每日轻量变化检查加每周一次全量分析,轻查只对比关键字段,变了才升级成完整研究。外挂 changedetection.io(35,234 星)可以在外面盯页面变化、只把通知递进来,避免为「看一眼」唤醒整个 agent。注意它自己的监控和托管成本要算进总账。上线前测三种情况:价格真变了(应触发分析)、纯排版变化(应记无变化)、页面打不开(应保持未解决)。
五、给成果设保质期
存报告只有一种意义:下一次运行知道还能不能信它。每份成果存五样东西——覆盖了什么问题、用了哪些输入、事实来自哪(来源链接和快照路径)、什么时候核实的、多久过期或什么变化要触发更新。
让 bot 先翻旧账再动手:
粒度是逐条判断的:公司背景介绍能扛很久,当期促销价格就得每次看。新的价格触发定价对比更新,背景资料原地不动——但基于旧价格做的那条建议也得跟着重推,这就是「结论依赖关系」要记录的原因。判断该不该复用的实操标准:这份结果回答的问题、用的输入、核实时间、刷新规则四样都对得上,才允许复用;四样里任何一样对不上,就当没有这份存档。快照缺了就补一次基线抓取,版本拿不准就查——这两件事都不是「假装没变化」的许可证。
六、一个任务一个负责人
多加 bot 常常是加活不是加产出:职责一重叠,两个 bot 研究同一个竞品、互相覆盖文件,token 翻倍产出不变。规则很简单:成品只有一个负责人;要加专家 bot,就给它一个明确独立的具体任务(某个源、某类分析),而不是「你也去研究一下竞品」。
给每个任务建记录:任务 ID → 负责人 → 输入 → 预期产出 → 检查项 → 状态。开工前先查记录里有没有进行中或已完成的工作,没有书面理由不许重复派活。交接必带四件套:产出路径、支撑证据、已做的检查、未解决问题。用一个协调者派活和更新状态,各干活的人写各自的输出文件。Grok Bot 的 bot 们共享同一台云电脑,分工不会带来文件隔离,文件组织要自己管好。任务记录一行就够:2026-10-19-northstar / 负责人-研究主理 / 输入-价格页与更新日志快照 / 预期-250 词简报 / 检查-计费口径与证据链 / 状态-进行中。跑完看一眼任务表:每个结果有且只有一个负责人,每个源只被收一次——除非有记录在案的理由。Bot 之间传活也一样,四个要素缺一个,接手的那个就会重做一遍你付过钱的研究。
七、失败不许拖垮全场
一个页面加载失败,应该只留下一个未解决的源,而不是让四份已经写完的简报跟着重新研究。在有用的边界上存进度:源已收集、证据已抽取、简报已起草、检查已通过——四个档位都能续。
把停止规则放在出事之前:
断点四档的实操含义:源已收集意味着不用再开网页;证据已抽取意味着不用再跑抽取工具;简报已起草意味着不用重写;检查已通过意味着这段结论冻结,任何重跑都不许碰它。只读型研究重试很简单;会「创建东西」的操作,重试前先确认第一次到底成没成,不然就是双份订单。如果重试由脚本控制,把上限也写进脚本,别全指望 bot 记性——工具给的是硬停止点,提示词给的只是自觉。验收方式:故意塞一个打不开的源,看它是「做完能做的、记录失败的、停止重试」,还是把全场推倒重来——后者说明停止规则还没生效。
八、让「完成」等于「能用」
省 token 省到最后一步翻车最亏:答案漏了关键限定词,你还得自己重写。开工前就把「能用」的标准说死。竞品简报的清单:重要论断都链到来源;价格必须带币种和月付/年付口径;变化要与带日期的历史版本对比;建议与事实明确分开;缺失的来源和未知项保持可见。
写完让 bot 自己过验收:
这五条各自防一种事故:链来源防「凭空断言」;币种加计费口径防「把年付折算价当月付价」这类数值事故;与带日期的历史版本对比防「把老闻当新闻」;建议与事实分开防「证据只够描述、话术却推你下单」;未知项可见防「沉默的缺口被当成不存在」。bot 嘴上说「已验证」不算证据,能用字段检查、对比、测试和查源解决的事就别靠它表忠心。课程里最典型的事故:竞品页面写着「$24/用户/月,按年计费」,初稿写成「月付订阅降价 20%,建议切换」——价格是真的,解读是错的,而且建议超出了证据范围。验收清单抓的就是这种错。测试方法:故意把「按年计费」从草稿里删掉,看验收能不能抓住并说清它为什么改变价格的含义。
九、组装成完整工作流
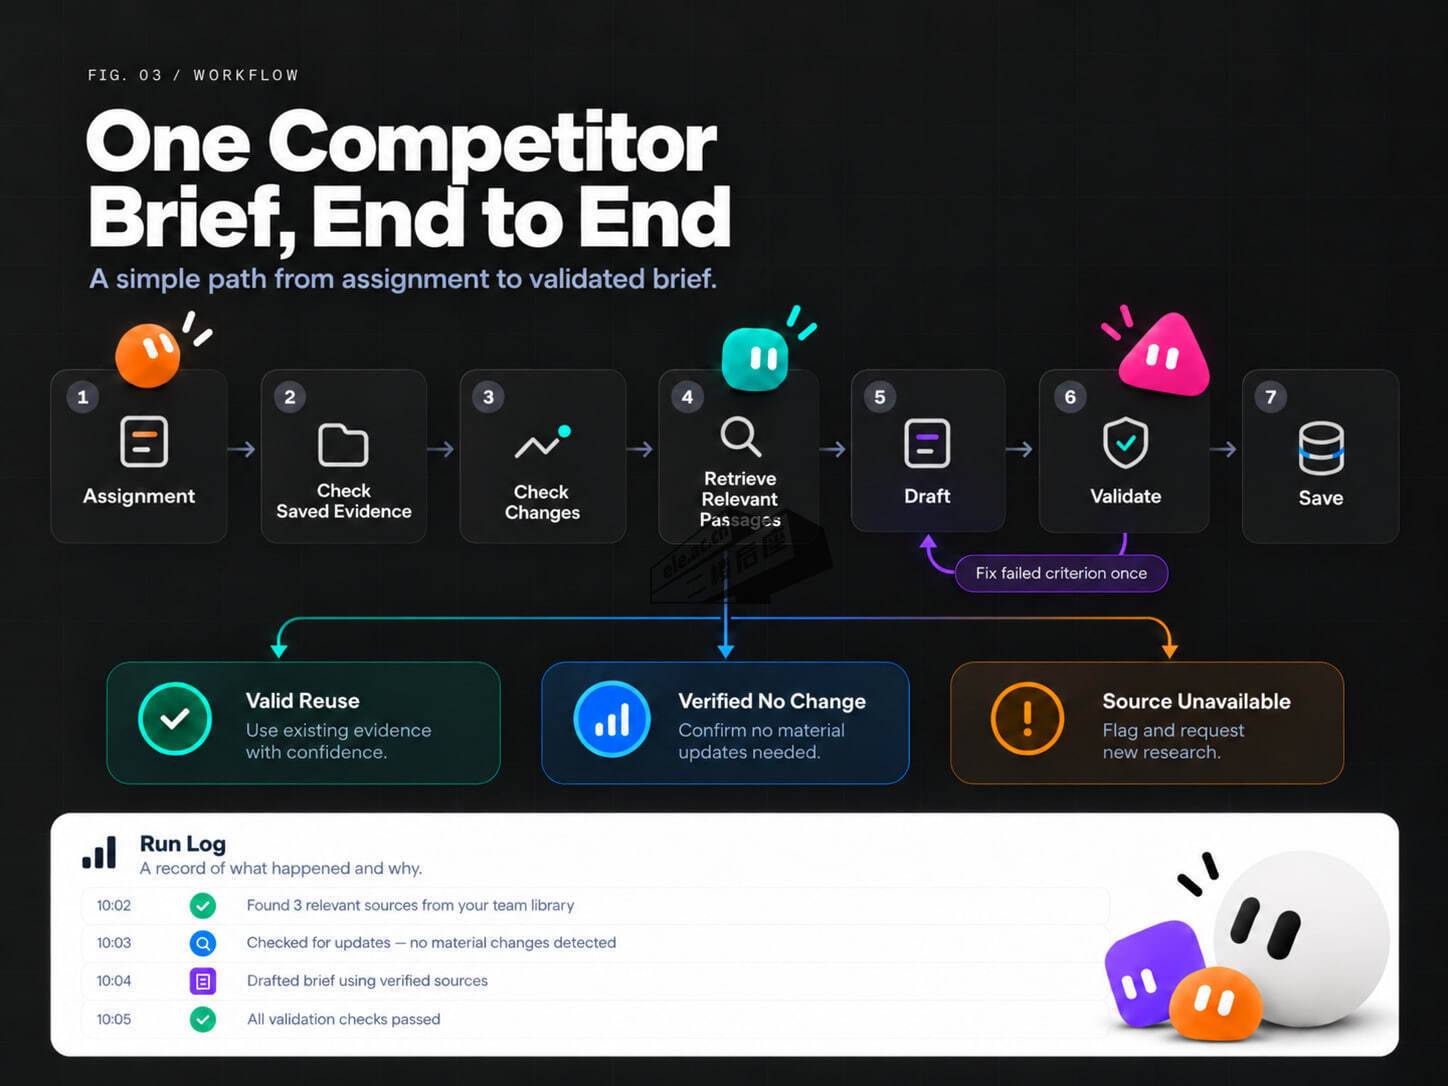
五个已批准的竞品、各自的价格页和更新日志 URL、一个带时区的每日截止时间——输入就这些。第一次运行抓基线,之后所有运行只做对比。课程里走了一遍完整流程:三家确认无相关变化,Northstar 改了年付报价,第五家更新日志打不开。于是产出四份通过验收的简报加一个明确标记的缺口。
看一个具体任务:「对比 Northstar 当前 Team 版定价和更新日志与上次成功快照,输出 250 词以内简报:变化、证据、业务含义、下一步。保留计费条款。除非证据覆盖我们的需求和切换成本,否则不建议切换。」页面快照显示年付从 30 美元降到 24 美元、月付 32 不变、5 席起。初稿写成了「月付订阅降价 20%,建议切换省钱」——两处 FAIL:计费口径与来源矛盾、切换建议没有证据支撑。定向修正一轮后,终稿写的是「年付口径从 30 降至 24,月付不变,5 席年付总投入 1,440 对 1,800 美元;是否切换还需确认老客户资格与切换成本」。初稿留作修订记录,不算第二次完成任务。
每天一行 run-log:task_id, status, source_outcome(有变化/无变化/抓取失败), retries, correction_passes, usage_tokens, evidence_path。用量量不出来就写 unknown,别编。日志长这样:2026-10-19-northstar, accepted, changed, 0, 1, unknown, sources/northstar/2026-10-19/;卡住的源单独一行,状态写 blocked,重试次数照实记——注意 retries 记的是首次之后的额外尝试次数,写 1 意味着总共试了两次。复盘时由你来补两列:这份产出你用上了没有、你花了几分钟修它。bot 能记下它做过哪些检查,但「结果是否满足你的需求」只有你能判。手动跑通一次之后,把整套流程存成私有 skill,再建一个写明负责人、时区和预期产出的例行日程。
十、算账:10 倍从哪来
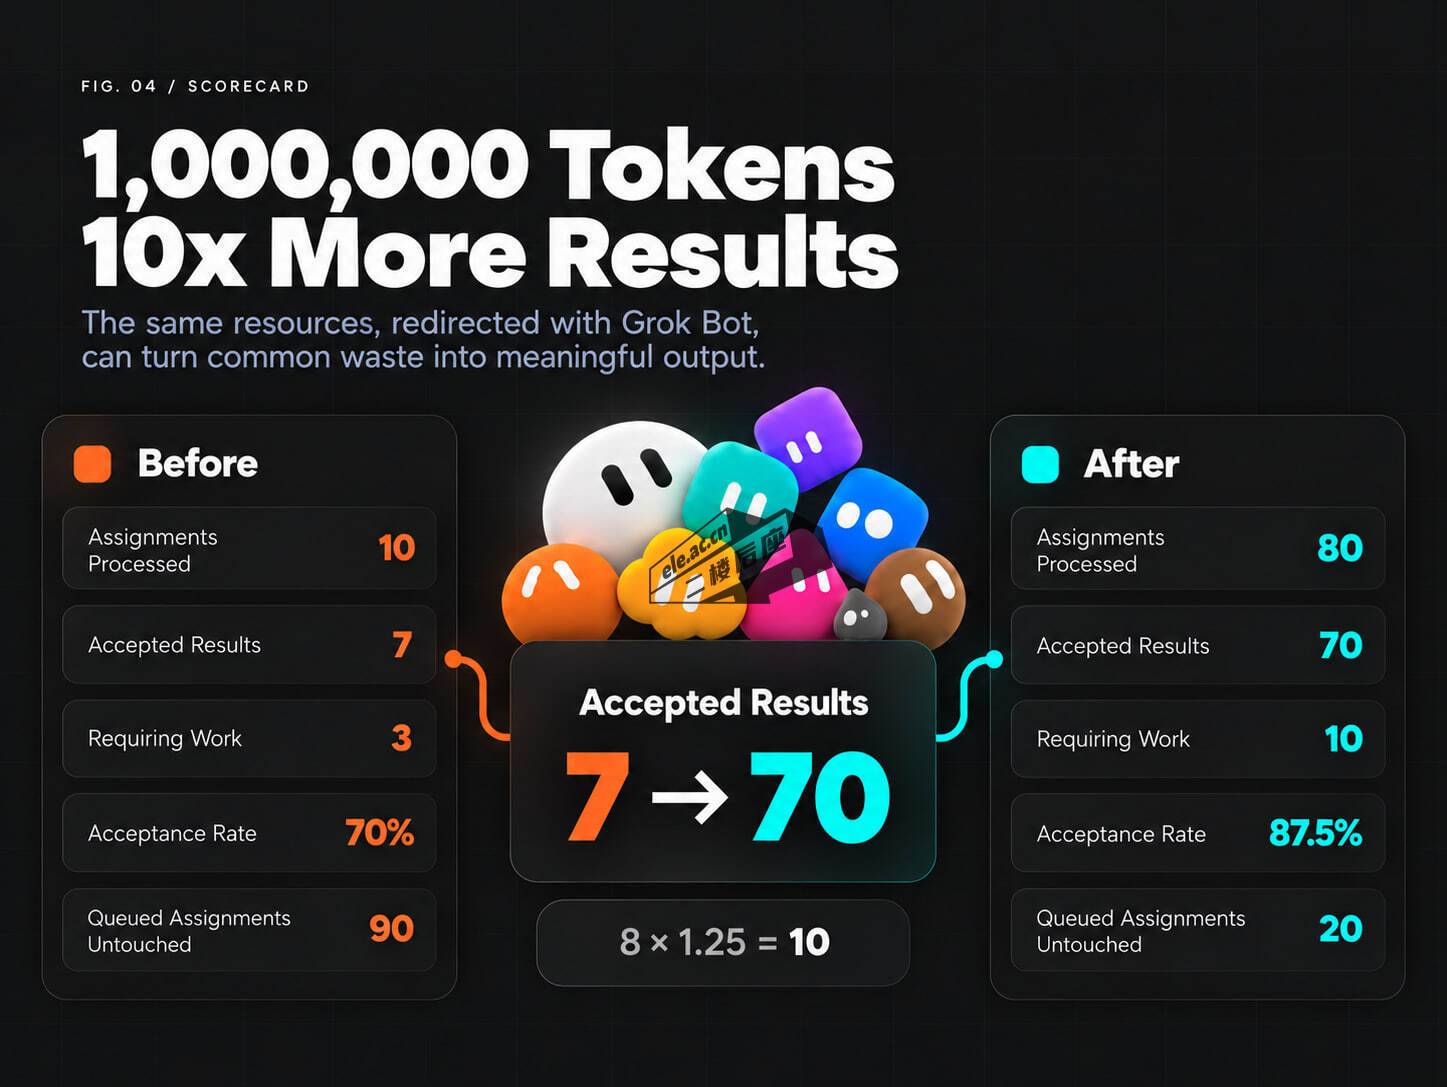
同一个任务、同一个「能用」标准,100 个排队任务、100 万 token 预算:改造前每任务 10 万 token、处理 10 个、7 份可用(通过率 70%),折合每份可用产出约 14.3 万 token;改造后每任务 1.25 万、处理 80 个、70 份可用(87.5%),折合约 1.43 万。8 × 1.25 = 10,但注意仍有 10 份要返工、20 个任务没跑到——工作流变好了,不是变完美了。
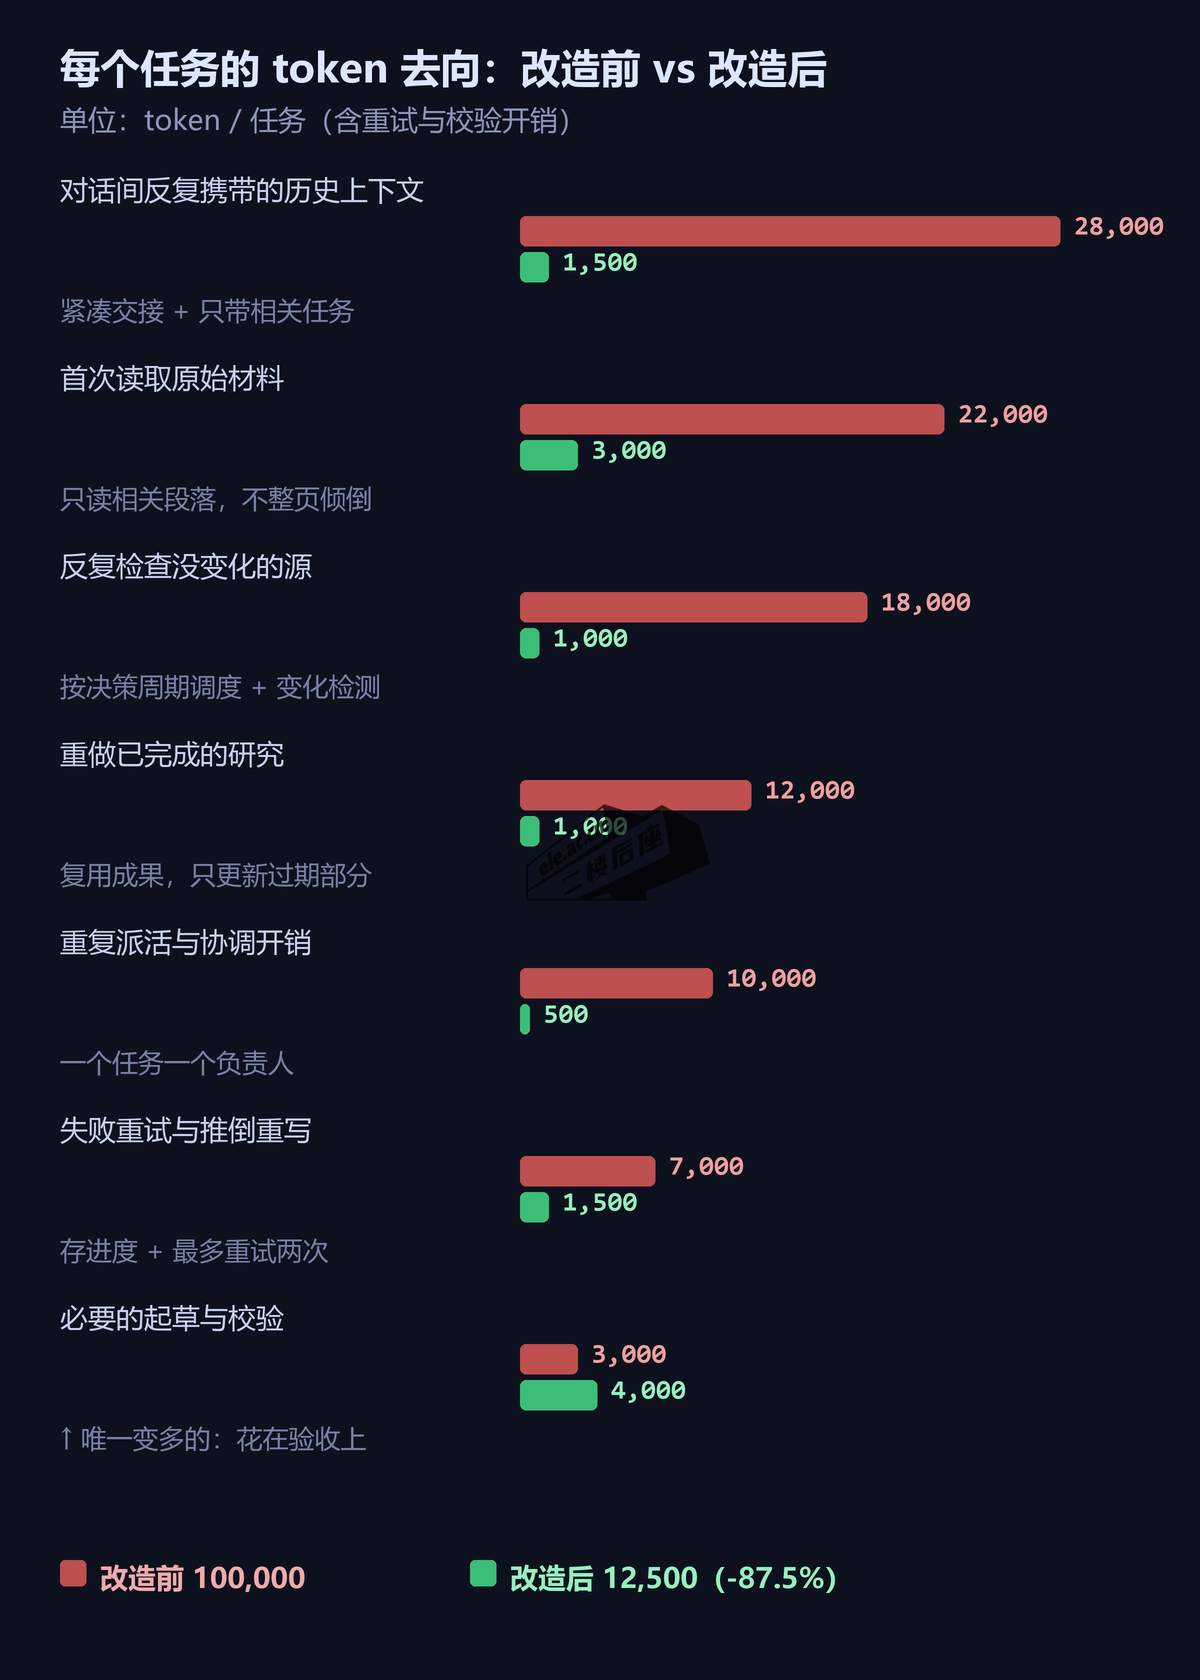
钱具体省在哪:对话携带的历史上下文 28,000→1,500,首次读源 22,000→3,000,重复检查没变化的源 18,000→1,000,重做已完成研究 12,000→1,000,重复派活 10,000→500,失败重写 7,000→1,500——唯一变多的是「必要的起草与校验」3,000→4,000,省下来的钱有一块是主动花在验收上的。三个七改造是乘法关系:小输入减少每次调用的读取量,成果复用消掉重复研究,断点让一次失败不再重启全局,少了哪一档账都算不平。
想让对比没法骗人:两版工作流喂同样的源、同样的顺序,混入无变化页面、真变化、过期信息、缺失计费条款和打不开的源,同一张验收清单盲评。一次只改一个大部件,先测检索、再测复用、再测调度,不然分不清是改动有效还是那天任务碰巧简单。记录字段:任务 ID、版本、状态、用量、工具调用数、重试数、耗时、人工修正分钟数、证据路径。还有一条记账纪律:同一笔 token 不许在两行里重复计——比如一次本不必要的轮询里读到的段落,归「重复检查」就不能再算「首次读取」;公共的架设和监控开销,要摊到它支撑的所有任务头上。「有变化通过」和「确认无变化」分开计数,防止工作流靠挑软柿子刷分。
先把审计跑了,再考虑掏钱升级
整套课程的顺序就一句话:找一个你明天还会重复执行的任务,先审计,改掉观察到的最大浪费,测完保留有效改动,再处理下一个。升级套餐只放大你现有的流程——包括它的浪费。审计、七个改造、组装提示词、度量模板,这篇都齐了,剩下的是挑个任务动手。
相关文章
- AI 从零开始详细教程:搞懂大模型、提示词和智能体,这一篇就够
- FreeLLMAPI 从零开始详细教程:把 34 家免费大模型聚合成一个 OpenAI 接口
- Muse 从零开始详细教程:让 AI 全权运营一个小红书账号,每天自动发两条
原帖:Gresham @ X(2026-10-20,29 万浏览)。文中 token 数据与流程均出自原帖,工具星数核实于 2026-10-23。








暂无评论内容