
PFN 在 11 月 5 日把翻译模型 PLaMo 3 Translate 的权重放上了 Hugging Face。学日语的人用得上的,是模型卡里那个叫 form 的参数:目标语言设成 ja,同一句话可以分别翻成常体和敬体两版日语,句尾落在「だ」还是「です」,在调用时就能定下来。最小的 0.8B 版本,GGUF 量化后 0.57 GB,自己的笔记本装得下。
这篇按「借 AI 学日语」来写:先看敬体常体到底差在哪,再把两版摆在一起做对照,最后说读长一点的日文材料时能加的三处设置。日文例句、参数和体积都出自官方模型卡和辞典,中文例句照着练习场景写。
敬体和常体,差别就在句尾
大辞泉「敬体」词条的定义是「文末に丁寧語『です』『ます』『でございます』などを用いた口語の文体」,别名「です・ます体」,词条末尾标着反义词「常体」。「常体」词条收了三个义项,第二个才是文法义:「文末に『だ』『である』を用いた口語の文体」,后面同样标着「敬体」。查的时候别引到第一义「普通の状態にあるからだ」。
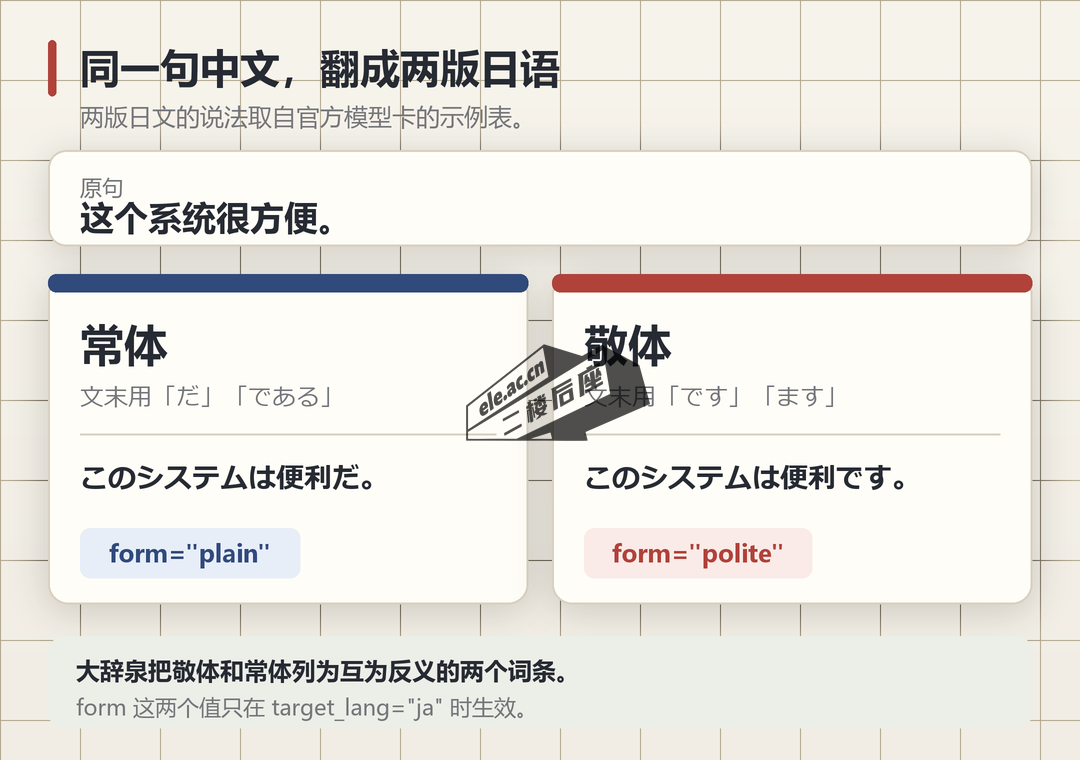
拿中文「这个系统很方便。」来举例。模型卡示例表里的两版日语是「このシステムは便利だ。」和「このシステムは便利です。」,前半句完全一样,只换了末尾。把中文原句摆在上面、两版日语并排放在下面,语尾这个位置就不用靠猜了。
把两版摆在一起,只改一个参数
form 有两个取值:plain 对应「だ・である」的常体,polite 对应「です・ます」的敬体。模型卡写明了两件事:这个参数只在 target_lang="ja" 时生效,也就是往日语里翻的时候;它要作为 apply_chat_template() 的参数传进去,不能写进 system message,也不能塞进原文。
照官方示例的结构,把原句换成中文:tokenizer.apply_chat_template([{"role":"user","content":"这个系统很方便。"}], source_lang="zh-hans", target_lang="ja", form="plain", add_generation_prompt=True)。模型卡把 source_lang 标为可选参数,form 换成 polite 就切到敬体。
模型卡还提了一句组合用法:如果一次请求里带了前几句的翻译历史,form 只作用于当前这一句,前面的译文不会被改写。做对照练习时,这个行为正好省事,可以一次拿两版。
方向也要说清楚。模型卡示例表用的是英文原句,上面换成中文之后,具体输出得自己跑一遍看。form 管的是日语输出,把日文翻成中文来读属于另一个方向,用不上这个文体开关;那一边能帮上忙的是下面三项。
读日文材料时,还能给模型三条信息
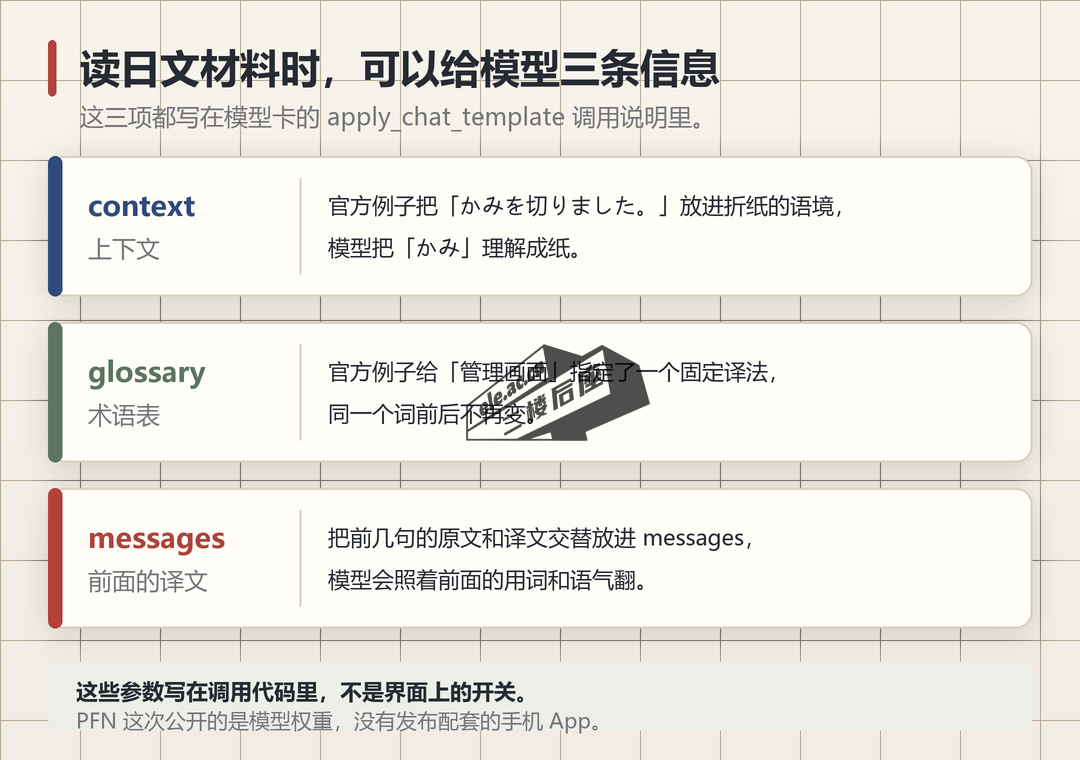
context 用来交代这句话出现在哪。模型卡的例子是「かみを切りました。」,单看分不清「かみ」是头发还是纸,加上「工作で折り紙を作っています。」之后,模型就按「纸」来译。glossary 用来固定词的译法,官方例子给「管理画面」和「プロジェクト」各指定了一个固定的英文对译,同一个词前后就不会变。这两个例子官方都是日译英,用来演示歧义和术语的处理。
第三项是前面的译文。模型卡里没有单独的 history 参数,做法是把前几句的原文和译文按 user、assistant 交替放进 messages,当前这句放在最后一条 user 里,官方说明是让模型接着前面的用词和语气翻。读连载、新闻、小说章节时,一段一段翻可以这么接。历史也占输入长度,模型卡给的上限是输入加输出合计 32768 token,长了就先丢最早的几句。
一份可以照着做的练习
先拿一句自己写好的中文,比如「今天下雨了。」,用 form="plain" 和 form="polite" 各翻一次,把两句日语抄在同一张卡片上,用笔圈出不同的结尾。第二天只看中文,自己写一遍敬体,再和卡片对一次。上面那句「这个系统很方便。」可以直接当第一张。
再找一段正在读的日文,比如一页小说或一则新闻,让它给中文对照。把这一页的出处和场景填进 context,把反复出现的人名、地名、专有名词写进 glossary,翻下一段时把上一段的原文和译文一起带上。读完之后,把没猜对的语尾单独记一行,隔几天再翻回来看。
模型小,材料可以留在本机
四个尺寸是 0.8B、2B、8B、31B,GGUF Q4_K_M 一档分别是 0.57 GB、1.81 GB、5.28 GB、19.53 GB,另外还有 BF16、FP8、W4A16、NVFP4 和 MLX-4bit。Windows、Linux 上可以用 llama.cpp 读 GGUF,苹果芯片用 mlx-lm 读 MLX-4bit。11 月 5 日的技术博文讲了这批权重和开发过程,同日的新闻稿里那张手机飞行模式翻译的截图,图注写明是演示环境。PFN 没有发配套 App,得自己接推理框架。
自己的课文、笔记、读书摘录不用贴到公网翻译框里,长期攒下来的语料可以留在机器上处理。许可证是 PLaMo Community License,PFN 的说法是「开放权重」,个人学习和非商业用途免费,不用提前登记;商用另有条件。起步先下 0.8B 的 GGUF,拿正在读的第一段日文跑一遍,够用再往上换尺寸。
站内还有几篇相关的:
Read Frog 从零开始详细教程:网页双语对照和划词查词。
告别死记硬背,学日语跟学母语一样简单:从听开始的一套日语学习法。
日语零基础课程-N1 全套学习资源:按阶段整理好的课程资料。






暂无评论内容