
先说结论:想让翻译内容留在自己设备里、断网还能翻,目前最稳的做法是在电脑上跑本地模型。腾讯混元 Hy-MT2 的 1.8B 版被官方用 1.25bit 量化压到 440MB,体积确实小到能塞进手机,但那个最小体积依赖一个到 2026 年 11 月 12 日还没合进 llama.cpp 主线的补丁,手机端也没有官方 App。今天就想跑通,选常规量化的 GGUF 更省事;非要用 440MB 那版,得自己编译一份带补丁的 llama.cpp。下面把能做的、不能做的、要自己动手的部分分开写清楚。
一、先对照一下你到底想解决什么
「离线翻译」这四个字底下其实混着好几种诉求,有的现在就能满足,有的还差一截。先把预期摆正,比装完再失望强。
| 你想做的事 | 现在能不能 | 说明 |
| 飞机上、没网的时候翻短句 | 能,电脑上 | 模型在本地,推理不联网 |
| 合同、会议纪要这类内容不传给第三方 | 能,但要连前端和剪贴板一起管 | 见第六节的三个出口 |
| 手机装个 App 就能用 | 暂时不行 | 官方只给了模型与 GGUF 文件,没有 Android / iOS 客户端 |
| 几百页文档、专业术语、实时对话 | 别指望 1.8B | 上下文 8192 token,端侧小模型的活儿是短句 |
| 省下每月的翻译订阅费 | 看用量 | 模型本身 Apache-2.0,但装与调要花时间 |
二、为什么要折腾本地模型:两笔账
第一笔是场景账。飞机上想把一句「请问转机柜台在哪」翻成当地语言,落地还没买卡、漫游流量不敢开,在线翻译这时直接不可用。第二笔是内容账:把合同草稿、病历、会议纪要整段贴进网页翻译框,等于把原文交给一台你管不着的服务器。这两件事都不需要多强的模型,需要的是「别联网」。
顺带把收费那一侧说清楚。DeepL Pro 官网中文页写的是 Individual 每月 €7.49、按年计费,Team 每用户每月 €24.99、按年计费,页面脚注注明价格已含增值税。同一页也写明 Pro 用户的文本不会用于训练模型、原文只在提供服务时临时存储。所以这里比的是「要不要把内容传出去」和「每月这笔钱值不值」,不是指责在线服务不安全。这两句话别混着读。
三、Hy-MT2 到底是什么
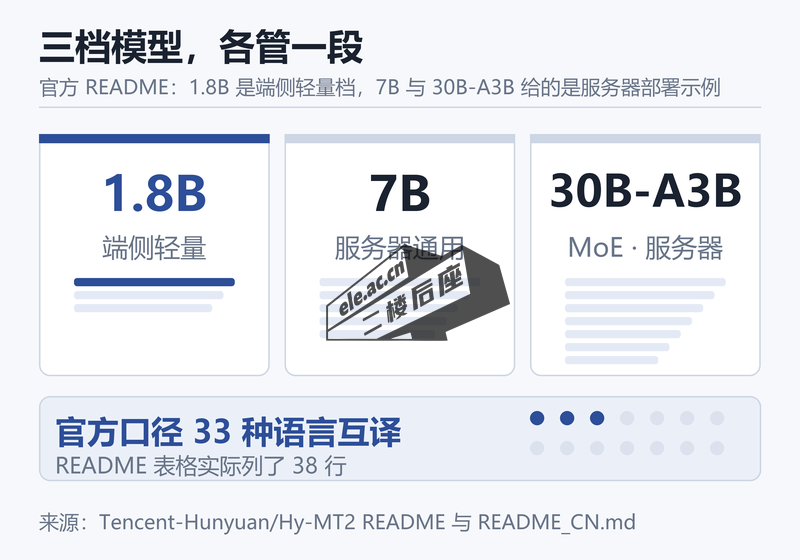
它是腾讯混元开源的多语言翻译模型家族,GitHub 仓库的 README 写的是面向真实复杂场景的「快思考」翻译模型,三个尺寸:1.8B、7B、30B-A3B(MoE)。2026 年 5 月 21 日开源,仓库最后一次代码推送是 8 月 26 日,到写这篇时已经过去一段时间,称不上「刚发布」。许可要看 LICENSE.txt 原文:文件抬头写着 Hy-MT2 is licensed under the Apache License, Version 2.0,后面是 Apache-2.0 全文。GitHub API 把这个仓库的 license 标成 NOASSERTION,原因是许可证文件带了自定义抬头,别照着 API 字段下结论。
| 尺寸 | 官方定位 | 这篇管不管 |
| 1.8B | 端侧部署,有 GGUF / FP8 / 2bit / 1.25bit 多种量化 | 管,整篇都围绕它 |
| 7B | 官方给了 FP8 与 GGUF,用 transformers / vLLM / SGLang 起服务 | 只作对照 |
| 30B-A3B(MoE) | 官方示例直接起 vLLM 服务 | 不在这篇范围 |
语言这块有个容易写错的地方。README 正文的口径是「支持 33 种语言互译」,但同一份 README 末尾的 Supported Languages 表格实际列了 38 行,把繁体中文、藏语、粤语、哈萨克语、蒙古语、维吾尔语等也单独列了进去。写 33 种是照官方口径,看到表格 38 行也别以为是数错了。另外 README 给的 max_context 是 8192,并特别注明模型没有默认 system_prompt,提示词得自己写全。
四、440MB 是怎么来的,以及为什么这 440MB 今天还不能直接跑
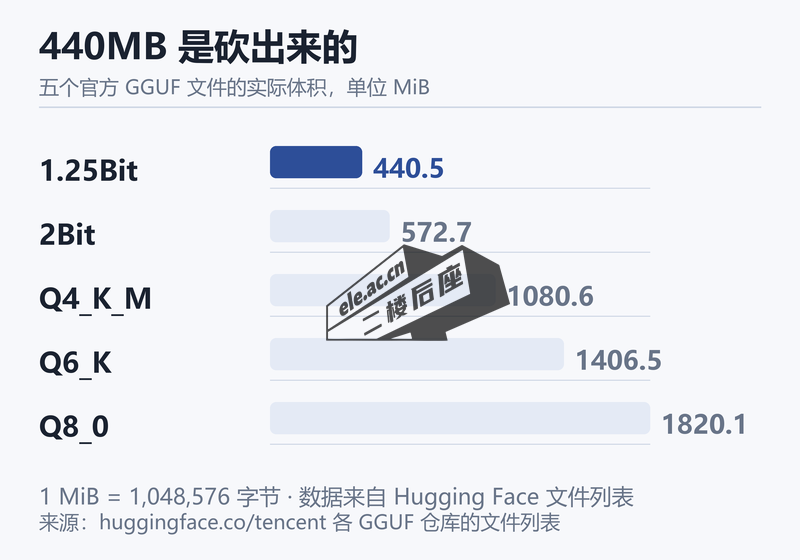
官方说法是用 AngelSlim 做 1.25bit 极端量化,把 1.8B 的存储压到 440MB,推理速度提升 1.5 倍。这句是 README 里的官方自述,没有第三方复测,照录并标明出处。Hugging Face 上那个 1.25bit GGUF 仓库里,Hy-MT2-1.8B-1.25Bit.gguf 的实际大小是 461,860,800 字节,换成 440.5 MiB,和官方口径对得上。
| 官方 GGUF 文件 | 实际体积 | 运行前提 |
| 1.25Bit.gguf | 440.5 MiB | 需要带 STQ kernel 的 llama.cpp,见下文 |
| 2Bit.gguf | 572.7 MiB | 官方单独列的 2bit 仓库 |
| Q4_K_M.gguf | 1080.6 MiB | 常规量化,普通 llama.cpp 就能加载 |
| Q6_K.gguf | 1406.5 MiB | 同上 |
| Q8_0.gguf | 1820.1 MiB | 同上 |
上面五个数字来自 Hugging Face 仓库的文件列表,按 1 MiB = 1,048,576 字节换算。看得出 440MB 这个卖点是把体积又砍了一半多,代价在下面这句。
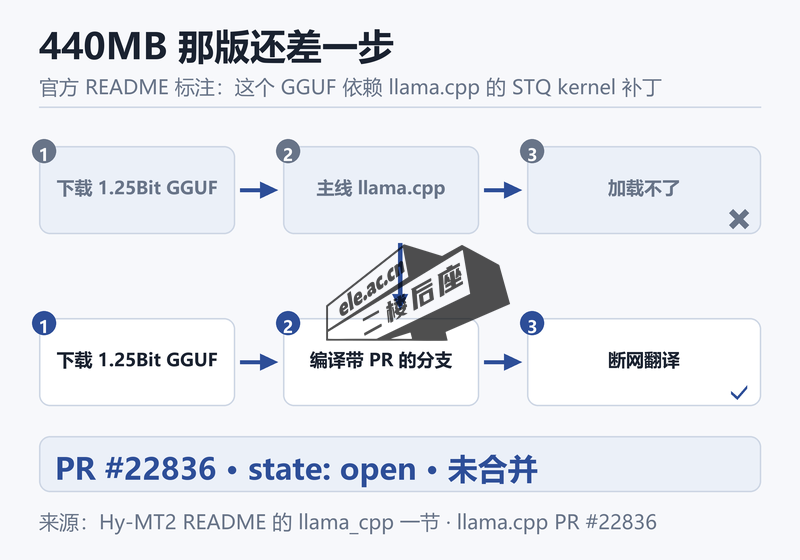
关键门槛:官方 README 在 llama_cpp 一节用两个感叹号开头写明,这个 GGUF 依赖他们提交的 STQ kernel,代码在 llama.cpp 的 PR #22836。查这个 PR 的状态,到 2026 年 11 月 12 日仍是 open、未合并,标题是 ggml-cpu : add STQ1_0 ternary quantization with ARM NEON vec_dot kernel。换句话说,直接拿主线 llama.cpp 去加载 440MB 那版,目前这条路是断的,得自己切到带该补丁的分支编译。这也是「手机装进口袋」这个说法要先按住的原因:连电脑端都要额外编译,手机端还要再叠一层前端适配。
五、三条落地路径,按动手量排
| 路径 | 要做什么 | 动手量 |
| 电脑本地跑 | 下 GGUF,编译 llama.cpp,命令行跑 llama-completion |
装一次,最省事 |
| 手机接前端 | 自己找能加载自定义 GGUF、且能套对 chat template 的前端,再解决 1.25bit 的 kernel 依赖 | 要动手,本文没实测 |
| 服务器跑 7B / 30B | 按官方示例起 vLLM 或 SGLang 服务 | 不在这篇范围,且内容又要过网络 |
电脑这条路的命令,官方 README 给的是先 clone、再 cmake 编译,然后跑 completion:
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
cmake -B build
cmake --build build --config Release

./build/bin/llama-completion \
  --model model.gguf \
  -p "Translate the following segment into Chinese, without additional explanation:Hello" \
  --jinja \
  -ngl 0 \
  -n 64 -st
命令里的 model.gguf 是占位,换成你下载的那个文件。--jinja 是让 llama.cpp 用模型自带的聊天模板,-ngl 0 表示全走 CPU。官方给的翻译提示词在中文 README 里写得更全,最常用的一句照抄即可:
将以下文本翻译为 英语,注意只需要输出翻译后的结果,不要额外解释:

今天天气真好。
README 还提醒,source_lang 与 target_lang 要写语言全称,中文提示词里用中文全称,英文提示词里用英文全称。1.8B 与 7B 的推荐推理参数是一样的:temperature 0.7 / top_p 0.6 / top_k 20 / repetition_penalty 1.05 / max_tokens 4096,30B-A3B 另有一组。
手机那条路我没法给出能抄的步骤。官方没有 App,具体哪个前端能正确套上这个模型的 chat template、1.25bit 的 kernel 在手机端怎么带进去,都没有实测过。这里不写「装某某就能用」,也不编测试截图。谁要往这个方向试,先按电脑端把模型跑通,再去解决前端,顺序反过来会很难定位问题。
六、隐私边界:本地推理不等于零风险
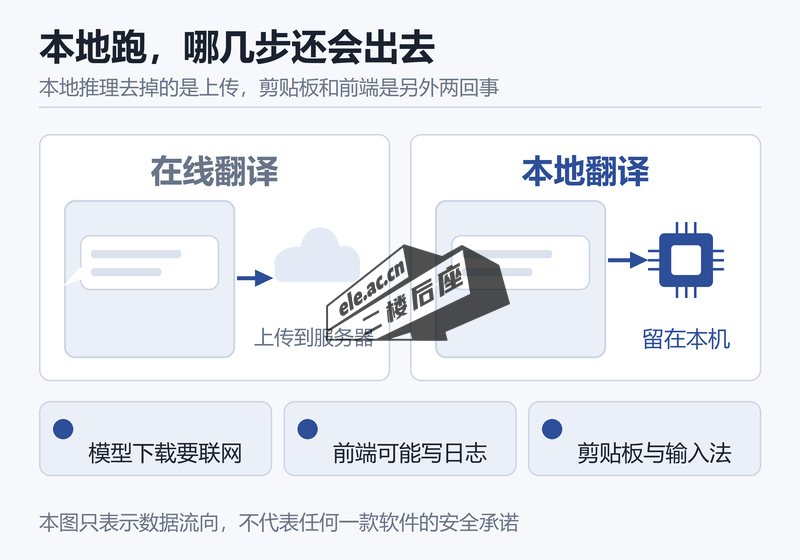
模型在自己机器上推理,你输入的那段文本确实不用发到第三方服务器,这是这件事最实在的收益。但把「文本不出设备」直接读成万无一失就过了,至少还有三个出口要自己看住:
- 下载环节要联网。模型文件、llama.cpp 源码、依赖库都得先联网拿回来,这一步和在线翻译无关,但也不是全程离线。
- 前端可能写日志。命令行、图形前端、输入法各自怎么处理历史记录,取决于你用的那一层,模型管不着。
- 剪贴板和输入法是另一个出口。把敏感内容复制进翻译框之前,它已经过了剪贴板;云输入法的联网行为跟本地模型是两码事。
对照着看会更清楚:DeepL Pro 官网写明 Pro 用户文本不用于训练、原文只在服务需要时临时存储;本地模型则是把「上传」这一步整个去掉。两条路各自解决什么、剩下什么风险,摆在一起才看得明白。
七、出国的时候,哪些场景离线够用
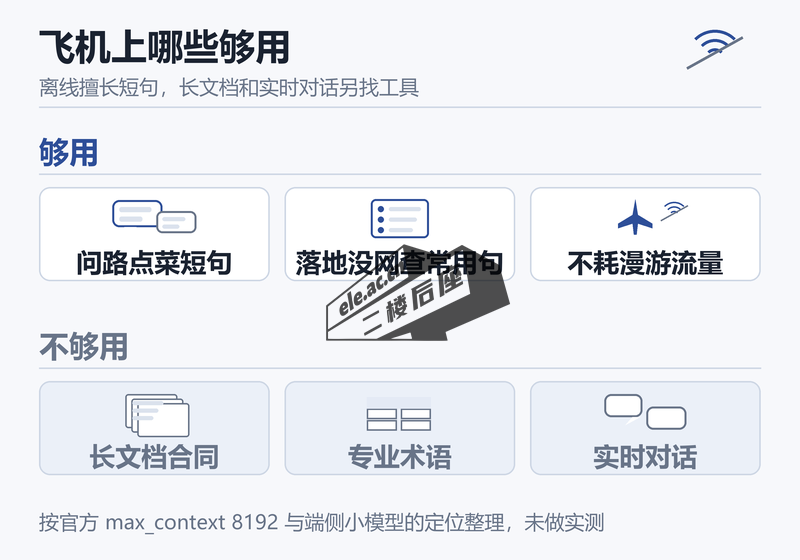
出门前把常用句先翻好、存进备忘录,是离线翻译最靠谱的用法。真到了柜台前临时组织一句长难句,小模型未必比手机自带的短语本强。
| 场景 | 离线够不够 | 建议 |
| 问路、点菜、check-in 这类短句 | 够 | 提前翻好存备忘录,飞机上也能查 |
| 落地没网、没买当地卡 | 够 | 模型文件提前下好,全程不耗流量 |
| 菜单、路牌拍照识别 | 不够 | 这是 OCR 的活,得先取字再翻译 |
| 合同、说明书这类长文档 | 不够 | 8192 上下文加小模型,先分段也要人复核 |
| 专业术语、实时对话 | 不够 | 术语走官方提示词里的对照表,对话另找工具 |
八、翻译质量:官方自评要标明,自己验也不难
README 里有一句很抓眼球:轻量 1.8B 在整体上超越了微软、豆包等主流商业 API,7B 和 30B-A3B 在快思考模式下超过 DeepSeek-V4-Pro、Kimi K2.6 等开源模型。这是腾讯自己的评测结论,不是第三方复测,写在这儿只作信息转述,别当成选型依据。官方把 1.8B 定位成端侧轻量档,7B 与 30B-A3B 给的是服务器部署示例;三档译文质量差多少,这篇没有跑过对照,不给排序。
同理,这篇也不编「中英、中日、中西各三句」的实测对照和译错案例,没跑过就是没跑过。想自己验,照下面这张清单走一遍比看别人的截图有用:
- 先用电脑端跑通官方 README 那句「今天天气真好。」,确认你下载的文件和 chat template 能出译文。
- 换一段带专有名词、数字和单位的中文,看模型会不会把名称音译错、把单位丢掉。
- 换一段需要敬体的日语,对照 用 AI 学日语:PLaMo 3 Translate 能指定敬体常体里那套思路,看 1.8B 能不能稳住语气。
- 把提示词换成官方给的「术语」「风格」「结构化数据」几组模板,看长句和带格式的内容会不会跑偏。
官方给了一整张翻译任务指令示例表,除了默认翻译,还有术语对照、风格、个性化、保留分隔符、结构化数据几类。{target_lang} 用语言全称,{source_text} 放原文,照抄改括号里的词就行,不用自己另编一套提示词。
九、和站内几篇怎么分工
翻译相关的文章站里已经有三篇,各自管的不是同一件事。Read Frog 从零开始详细教程解决的是看外文网页,浏览器里出双语对照;用 AI 学日语:PLaMo 3 Translate 能指定敬体常体是日语专用,重点在敬体常体;这篇管的是没网、或者不想把内容传出去的场景,语言面也宽得多。三篇互相补,不用挑一篇当唯一答案。要顺手看看还有哪些收费软件能换掉,免费开源替代清单里按类分好了。
十、上手清单,以及三个别踩的坑
- 先在电脑上下常规量化的 GGUF(比如 Q4_K_M),按官方命令编译 llama.cpp 跑通一句翻译。
- 确认提示词用语言全称、只输出译文,别让模型顺手加解释。
- 出国前把常用句翻好存进备忘录,把模型文件提前下完。
- 处理敏感材料时,连前端日志、剪贴板、输入法一起检查。
三个坑单独拎出来:440MB 那版依赖未合并的 STQ 补丁,别拿主线 llama.cpp 硬试;手机端没有官方 App,本文也没实测过任何前端,别照着「装进口袋」的宣传直接下单;1.8B 是轻量档,长文档和专业术语别交给它一个人扛。想清楚了再动手,比装到一半发现跑不起来省时间。






暂无评论内容